NOVA und Muse Glimmer 30B: Präzision für Code und Werkzeuge
Executive Summary
Muse Glimmer 30B von Meta richtet sich auf lokale Agentenaufgaben. Das Modell kombiniert einen dichten Sprachdecoder mit Bildverarbeitung und wurde unter anderem für Tool-Nutzung und Fehlerkorrektur trainiert. Für NOVA sehen wir darin einen Kandidaten für Entwicklungsaufgaben und Abläufe mit definierten Schnittstellen.
Die offizielle Modellkarte nennt für eine quantisierte Variante auf der RTX 5090 durchschnittlich 233,4 Tokens pro Sekunde mit DFlash, gegenüber 74,9 ohne spekulative Decodierung. Das sind Herstellermessungen mit einer bestimmten Konfiguration, keine Ergebnisse unserer Windows- und Ollama-Installation.
Wie ein solches Modell mit euren Anwendungen zusammenarbeitet, hängt von der NOVA-Anbindung und den festgelegten Freigaben ab. Ein präzises Modell ist dabei eine Komponente des Systems; es legt seine Berechtigungen nicht selbst fest.
Brauchen wir wirklich noch ein Modell?
Manchmal erscheint ein neues Open-Weight-Modell und man fragt sich zunächst: Brauchen wir davon wirklich noch eines?
Bei Muse Glimmer 30B lohnt sich ein genauerer Blick. Ein produktives Unternehmens-KI-System soll schließlich nicht nur Fragen beantworten. Es soll Dinge tun können.
Code analysieren. Eine Funktion aufrufen. Ein Ergebnis überprüfen. Einen Fehler erkennen. Einen zweiten Versuch vorbereiten. Und anschließend entscheiden, welcher Prozessschritt als Nächstes sinnvoll ist.
Das trifft einen Bereich, der für NOVA zunehmend relevant wird. Nicht weil jedes Modell sofort jeden Ablauf übernehmen soll, sondern weil wir für solche Aufgaben passende Komponenten auswählen und ihre Zusammenarbeit erproben wollen.
»Fast richtig« ist an einer Schnittstelle oft falsch
Ein Modell kann einen hervorragenden Absatz formulieren und trotzdem ein schlechter Software-Agent sein. Sobald eine Antwort Teil einer Entwicklungs- oder Automatisierungskette wird, gelten andere Regeln. Ein Funktionsname stimmt oder er stimmt nicht. Ein Parameter gehört an eine bestimmte Stelle. Ein JSON-Objekt entspricht dem erwarteten Schema – oder der nächste Schritt schlägt fehl.
»Fast richtig« ist bei maschinenlesbaren Schnittstellen häufig schlicht falsch. Deshalb interessiert uns bei Muse Glimmer besonders die Kombination aus Tool-Nutzung und Fehlerkorrektur. Die offizielle Modellkarte von Meta beschreibt diese Fähigkeiten als Trainingsziele.
Ein Fehler ist noch kein Anlass zum Aufgeben
Ein Werkzeug kann einen unerwarteten Rückgabewert liefern. Ein API-Aufruf kann scheitern. Ein brauchbarer Agent sollte dann nachvollziehen können, was passiert ist, statt den Vorgang kommentarlos liegen zu lassen.
In NOVA würden wir das als begrenzten Ablauf gestalten: Rückgabe prüfen, einen zulässigen nächsten Schritt vorbereiten und bei wiederholtem Fehler an das zuständige Team übergeben. Die Fähigkeit eines Modells zum erneuten Versuch ist keine Erlaubnis für unbegrenzte Wiederholungen. Das ist insbesondere dann wichtig, wenn ein Aufruf Daten verändert.
Muse Glimmer kann visuelle Informationen einbeziehen
Meta kombiniert das dichte Modell mit einem Perception Encoder. Damit lassen sich Text und Bilder gemeinsam verarbeiten. Ein Screenshot einer fehlerhaften Oberfläche kann so neben der zugehörigen Beschreibung stehen. Die Analyse muss sich nicht auf einen nachträglich formulierten Textbericht beschränken.
Für unsere Arbeit ist das eine nützliche Perspektive: Ein Team könnte den sichtbaren Fehler zeigen und eine Erklärung dazu geben. NOVA würde daraus einen Vorschlag für die weitere Untersuchung vorbereiten. Ob dieser Vorschlag stimmt, lässt sich anschließend am Code und am reproduzierbaren Fehlerbild prüfen.
NOVA am Reparaturplatz
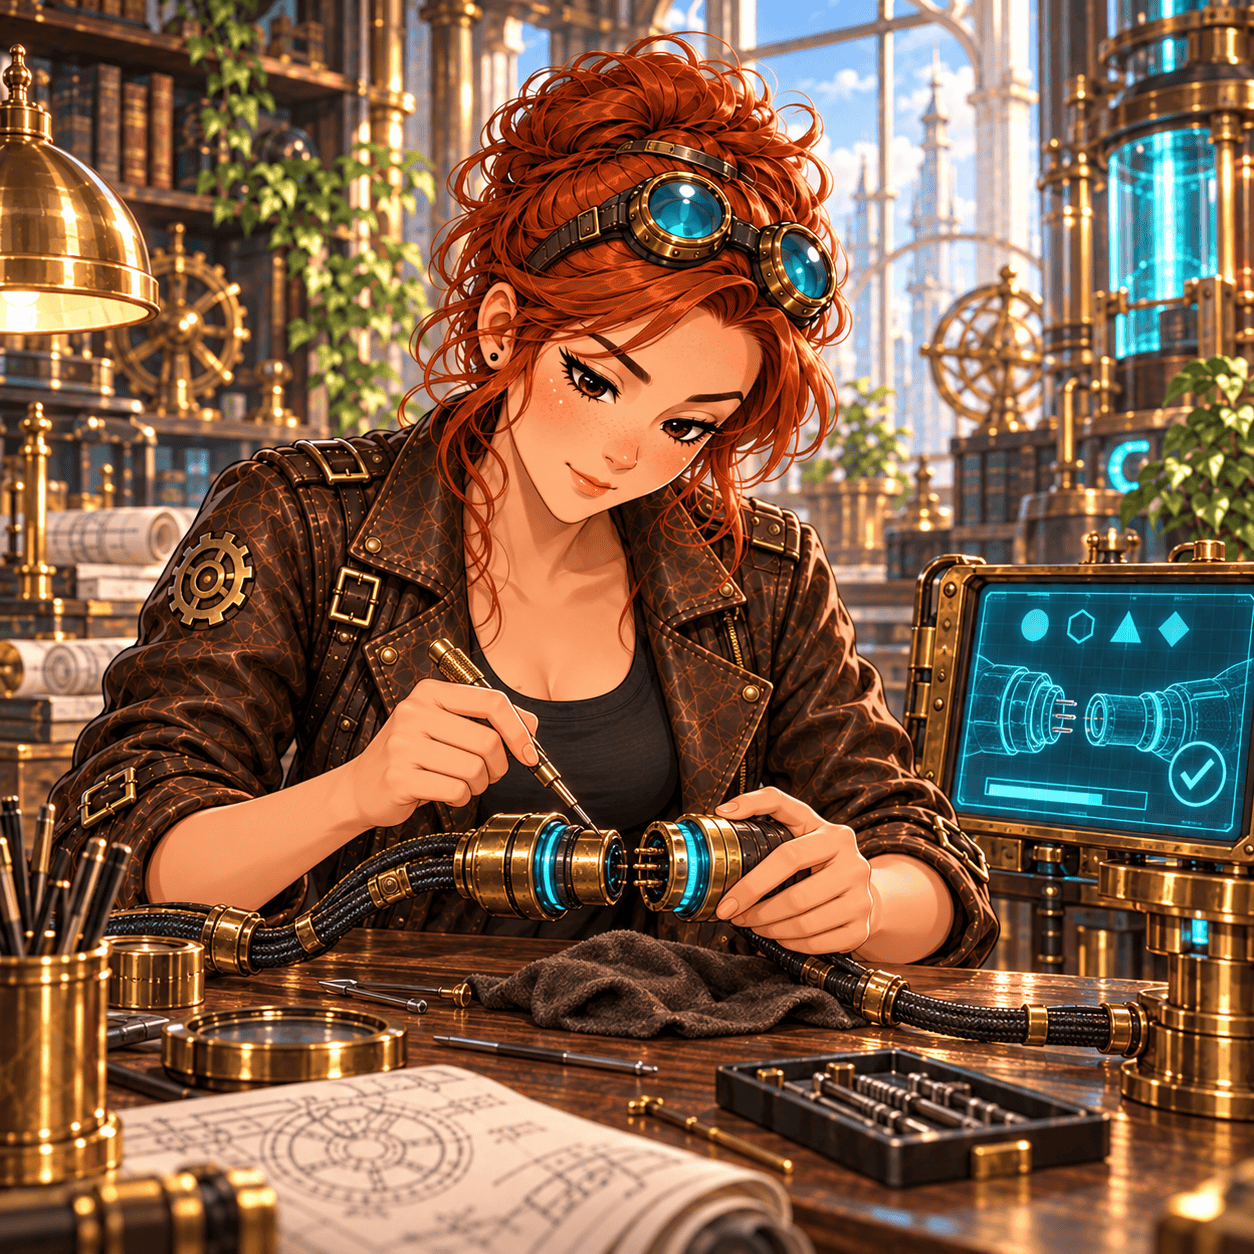
In unserer Illustration steht NOVA mit einem Präzisionswerkzeug an einer unterbrochenen Verbindung. Der Blick richtet sich auf das passende Gegenstück. Diese Szene erzählt, was uns an Muse Glimmer interessiert: verstehen, warum ein Schritt nicht funktioniert hat, und die Verbindung kontrolliert wiederherstellen.
Ein denkbarer Unternehmensfall beginnt mit einer importierten Datei. Ein Feld ist unvollständig oder das Zielformat weist den Datensatz zurück. NOVA könnte die Rückmeldung erklären und eine Korrektur vorschlagen. Bevor erneut übertragen wird, prüft die Anbindung, ob der erste Versuch bereits etwas gespeichert hat. So vermeiden wir, dass aus einem Wiederholungsversuch eine doppelte Buchung wird.
Wie NOVA Informationen an bestehende Anwendungen übergibt, zeigen wir auf der Seite zur API-Integration. Wer welche Daten sehen und welche Aktionen freigeben darf, gehört in die Planung von Governance und Sicherheit.
DFlash: Vorschlagen, prüfen und übernehmen
Bei spekulativer Decodierung schlägt ein kleineres Drafter-Modell mögliche Textfortsetzungen vor. Das Zielmodell prüft sie. Ein passender Vorschlag kann übernommen werden, ohne dass jedes Token vollständig nacheinander erzeugt werden muss.
Meta veröffentlicht für seine RTX-5090-Konfiguration die genannten 74,9 beziehungsweise 233,4 Tokens pro Sekunde. Gemessen wurde mit Batchgröße 1, greedy Decoding und llama.cpp an einem gemischten Prompt-Satz. Diese Konfiguration ist für uns ein Anhaltspunkt, aber kein pauschales Versprechen für Ollama.
DFlash benötigt den passenden Drafter und einen unterstützten Ausführungspfad. Das Basismodell herunterzuladen oder ihm einen Namen mit »fast« zu geben, genügt nicht. Wir vergleichen eine sauber dokumentierte Basis mit der tatsächlich eingerichteten beschleunigten Variante.
32 GB sind ein Budget, keine pauschale Zusage
Unsere Windows-Umgebung mit RTX 5090 und 32 GB VRAM ist der vorgesehene Prüfstand. Die vorliegende Ollama-Liste zeigt Muse Glimmer als rund 18 GB große Datei. Für den Betrieb zählen außerdem der Kontextspeicher, die Bildverarbeitung und gegebenenfalls der Drafter.
Wir möchten deshalb unterschiedliche Konfigurationen gegeneinander abwägen. Mehr Präzision bei den Gewichten kann nützlich sein. Mehr Speicherreserve für eine längere Aufgabe ebenso. Quantisierung ist nicht nur eine Notlösung zum Einsparen von VRAM; sie beeinflusst, welche Arbeitslast sinnvoll in die vorhandene Hardware passt.
Ob eine einzelne Entwicklungsaufgabe flott reagiert und ob mehrere parallele Anfragen gut laufen, sind unterschiedliche Prüfungen. Die Modellkarte ersetzt keine Lastmessung unseres Systems.
Was würde Muse Glimmer in NOVA übernehmen?
Als möglicher Coding-Assistent könnte das Modell ein bestehendes Projekt erklären, einen Fehler untersuchen oder einen Änderungsvorschlag mit passenden Tests vorbereiten. Der Quellcode muss dafür nicht zwingend an einen externen Dienst übertragen werden; welche Datenwege zulässig sind, legen wir für die konkrete Installation fest.
Für die erste Erprobung würden wir eine überschaubare Aufgabe wählen. Ein bekanntes Fehlerbild, ein begrenzter Codebereich und ein prüfbares Ergebnis sind besser als ein offener Auftrag, »das ganze System zu verbessern«. Diese Haltung prägt auch unsere NOVA-Anwendungsfälle.
Muse Glimmer ergänzt damit die Idee des Aufgabenverteilers aus dem Nemotron-Artikel. Ein häufig aufgerufenes Ausführungsmodell und ein Modell für längere Untersuchungen können unterschiedliche Rollen übernehmen. Welche Rolle tatsächlich passt, entscheiden wir anhand der Ergebnisse. Die NOVA-Modellauswahl beschreibt, wie Aufgabe und Ausführung zusammengehören.
Du möchtest einen Entwicklungs- oder Datenprozess auf diese Weise erproben? Auf der NOVA-Hauptseite könnt ihr euren Ablauf beschreiben. Ausgangspunkt bleibt die konkrete Arbeit, die am Ende besser erledigt sein soll.
Persönliches Gespräch gefällig?

Autor
Prof. Dr. Alexander Lutz, Professor für Big Data und KI an der FOM München, Doktor der Humangenetik und Anthropologie, ehemaliger Onlinespiele-Designer und natürlich Gründer und Inhaber der Agentur Die NEOs. Neben den Themen der künstlichen Intelligenz und deren Einsatzmöglichkeiten in der Praxis konzentriert sich Alexander auf die Kundenkommunikation. Neue Problemfelder oder technische Innovationen bereitet er so auf, dass der Nutzen für unsere Kunden deutlich wird. Er schläft zeitverantwortlich und agiert schnell, sein Motto: “Tue es, oder tue es nicht. Es gibt kein Versuchen.”
 Die NEOs – KI-generiert
 Die NEOs – KI-generiertNOVA und Qwen3.8 27B: Wenn Dokumente mehr als Text sind