NOVA und Qwen3.8 27B: Wenn Dokumente mehr als Text sind
Executive Summary
Qwen3.8 27B verbindet Textverarbeitung mit nativer Bild- und Videoverarbeitung. Die offizielle Modellkarte beschreibt ein dichtes Modell mit 262.144 Tokens nativem Kontext, steuerbarem Reasoning und Multi-Token Prediction. Für NOVA interessiert uns besonders, wie sich technische Dokumente mit ihren Abbildungen gemeinsam betrachten lassen.
Unsere Windows-Umgebung mit RTX 5090 und 32 GB VRAM ist der vorgesehene lokale Prüfstand. Unsere Modellliste weist eine rund 17 GB große Qwen3.8–27B-Datei aus. Daraus folgt noch keine Aussage über den Speicherbedarf mit Bildverarbeitung und langen Kontexten.
Dokumentenverständnis ergänzt ein sauber eingerichtetes NOVA-Wissenssystem mit RAG. Es ersetzt weder die Quellenzuordnung noch die fachliche Prüfung einer Antwort. Den Unterschied zwischen dem offiziellen 27B-Modell und Community-Distill-Versionen halten wir dabei ausdrücklich fest.
Was bekommen wir auf unserer Hardware davon zum Laufen?
Bei Qwen haben wir uns inzwischen daran gewöhnt, dass neue Modellgenerationen nicht lange auf sich warten lassen. Interessanter als die Versionsnummer ist für uns aber die Frage, was sich im Alltag tatsächlich verändert.
Unsere zentrale Frage bei neuen Open Models lautet nicht: »Wie groß ist es?« Sondern: »Was bekommen wir auf unserer Hardware tatsächlich davon zum Laufen?«
Das klingt ähnlich, ist aber ein deutlicher Unterschied. Ein Modell kann gute Benchmarks erzielen und trotzdem eine Infrastruktur benötigen, die für eine lokale Unternehmensinstallation nicht sinnvoll ist. Die 27B-Klasse liegt dagegen in einer Größenordnung, die wir auf unserem vorhandenen Prüfstand konkret untersuchen können.
Groß genug für anspruchsvolle Aufgaben. Klein genug, um den Betrieb auf einem einzelnen leistungsfähigen Desktop-System zu erproben. Ob diese Kombination für eure Aufgabe reicht, zeigt sich an deren Ergebnis – nicht an der Parameterzahl allein.
Ein Dokument besteht nicht ausschließlich aus Wörtern
Ein klassisches Textmodell bekommt beispielsweise den extrahierten Text einer PDF. Ein multimodales Modell kann zusätzlich die eigentliche Seite betrachten. Das macht für viele Wissensaufgaben einen Unterschied.
In einem Handbuch kann eine Verbindung erst durch ihre Position in der Zeichnung verständlich werden. Ein Diagramm ordnet Messwerte zu. Eine Tabelle enthält Überschriften, deren Bezug beim bloßen Extrahieren verloren geht. Genau deshalb interessiert uns die gemeinsame Verarbeitung von Text und visuellen Informationen.
Die offizielle Modellkarte von Qwen3.8 27B dokumentiert die Unterstützung für Bilder und Videos. Daraus leiten wir mögliche Einsatzaufgaben ab; ein fehlerfreies Verständnis jeder Zeichnung ist damit nicht bewiesen.
NOVA liest und betrachtet
Stellen wir uns eine technische Rückfrage im Service vor. In der Beschreibung steht eine Gerätenummer, auf der beigefügten Seite ist die Anschlusszeichnung zu sehen. NOVA könnte die relevante Textstelle mit der Abbildung zusammenführen und einen Hinweis für das Team vorbereiten.
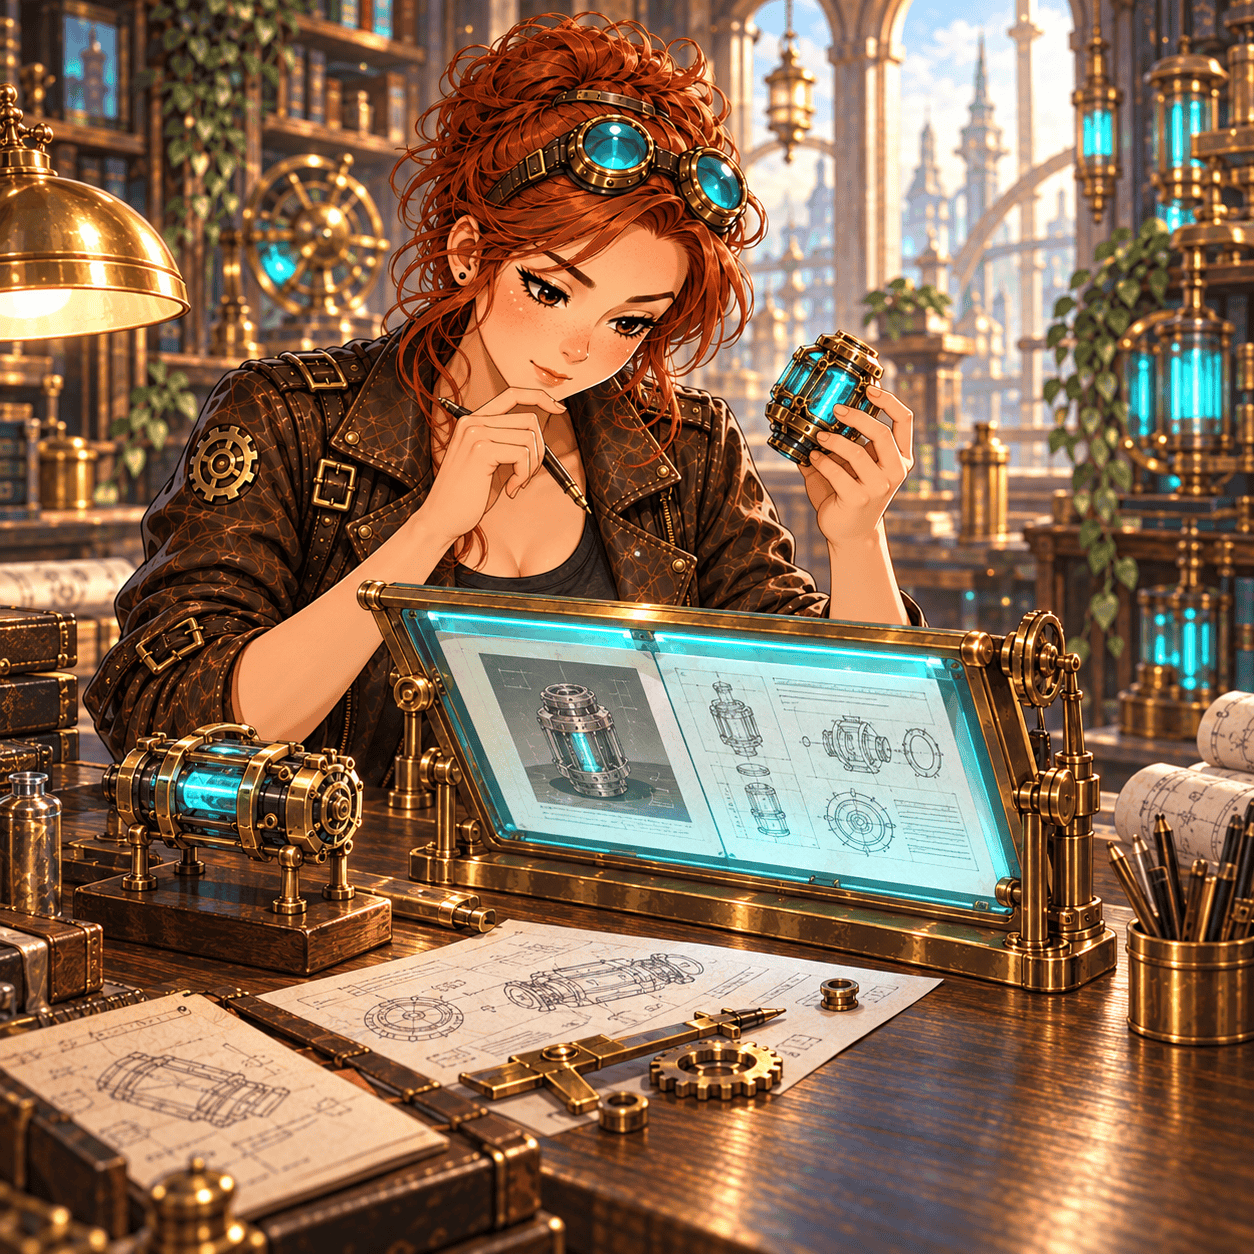
In unserer Bildwelt betrachtet sie dafür ein Dossier durch einen beleuchteten Dokumentenbetrachter. Es ist eine Illustration des Ablaufs, kein Screenshot und keine Behauptung menschlichen Sehens. Die reale Anwendung muss nachvollziehbar zeigen, welches Dokument und welche Fassung die Antwort stützen.
Für eine produktive Anwendung planen wir auch den Fall, dass eine Zeichnung unscharf oder ein Bezug nicht eindeutig ist. Dann ist eine Rückfrage oft hilfreicher als eine überzeugend formulierte Vermutung. Die Grenzen der Aufgabe gehören zur Einrichtung.
Ein großer Kontext ersetzt kein gutes Retrieval
262.144 Tokens nativer Kontext geben dem Modell grundsätzlich Platz für umfangreiche Zusammenhänge. Die tatsächlich nutzbare Länge hängt aber von der lokalen Konfiguration und dem verfügbaren Speicher ab. Wir geben dem Modell deshalb nicht pauschal den gesamten Dokumentenbestand.
Für NOVA werden Unterlagen vorbereitet und die für eine Frage relevanten Informationen ausgewählt. Die Seite Wissen und RAG erklärt diese Verarbeitung. Ein langes Kontextfenster kann dann Reserve für eine größere Aufgabe bieten, während die Quellen weiterhin gezielt zugeordnet bleiben.
Wie viel Modell passt sinnvoll auf die RTX 5090?
Qwen3.8 27B ist ein dichtes Modell. Anders als bei einem MoE-Modell mit wenigen aktiven Experten arbeitet der Sprachpfad mit seiner gesamten Parameterstruktur. Das allein entscheidet noch nicht über die Reaktionszeit, ist aber ein wesentlicher Unterschied für den Vergleich.
Unsere 32-GB-Karte ist der Prüfstand für quantisierte Varianten. Die rund 17 GB in unserer Modellliste bezeichnen die gespeicherte Datei. Für Laufzeit, Kontext und visuelle Komponenten braucht es zusätzlichen Platz. Ob ein konkreter Ablauf vollständig im Grafikspeicher bleibt, prüfen wir während der Ausführung.
Q4 oder Q5? Die Aufgabe entscheidet
Wir würden nicht automatisch die stärkste Kompression wählen. Wenn ein etwas genauer quantisiertes Modell wichtige Bezüge zuverlässiger erkennt und genügend Speicherreserve bleibt, kann diese Variante sinnvoll sein. Wenn die Aufgabe längere Dokumente oder mehrere Bildseiten benötigt, ist zusätzlicher Platz vielleicht wertvoller.
Diese Abwägung braucht Messungen mit demselben Material. Eine Dateigröße erlaubt eine erste Planung. Sie beantwortet noch nicht, welche Konfiguration im konkreten Arbeitsablauf die brauchbareren Antworten liefert.
Reasoning und Beschleunigung sind Konfiguration
Qwen beschreibt steuerbare Reasoning-Stufen und ein Training mit Multi-Token Prediction. Wir möchten die verfügbare Rechenzeit passend zur Aufgabe einsetzen: Eine einfache Zuordnung braucht nicht zwangsläufig denselben Aufwand wie eine technische Ursachenanalyse.
Welche Steuerung und welche Beschleunigung tatsächlich verfügbar sind, hängt vom verwendeten Backend und dessen Version ab. Die Modellkarte beschreibt Möglichkeiten; für Ollama prüfen wir den konkreten Ausführungspfad. Ein installiertes Modell ist noch keine aktivierte MTP-Konfiguration.
Und die angekündigte zweite Qwen-Spitze?
Der ursprüngliche Artikelentwurf wartete noch auf eine offizielle Qwen3.8–35B-A3B-Veröffentlichung. Für unsere jetzige Reihe halten wir die Modelle genauer auseinander. Qwen3.8 27B stammt vom Qwen-Team. Die von Empero veröffentlichte Qwen3.8–35B-A3B-Distill-Version ist eine Community-Distillation auf Basis der Qwen3.6–35B-A3B-Architektur.
Wir behandeln sie deshalb nicht als gleichwertige offizielle Variante derselben Veröffentlichung. Im geplanten Vergleich treten das originale Qwen3.6–35B-A3B und die Community-Distill-Version gegeneinander an. Ein höher klingender Name ersetzt keine nachvollziehbare Herkunft und keine eigene Prüfung.
Welche Rolle bekommt Qwen in NOVA?
Für NOVA sehen wir Qwen3.8 27B als Kandidaten für Aufgaben, bei denen Dokumenttext und visuelle Hinweise zusammengehören. Ein technisches Handbuch, ein Diagramm oder eine dokumentierte Oberfläche sind gute Ausgangspunkte für eine begrenzte Erprobung.
Welches Modell die Aufgabe übernimmt, wollen wir anhand des benötigten Ergebnisses entscheiden. Die NOVA-Seite zu Modellen und Inferenz erklärt diese Auswahl. Aus einem Modellpark wird erst dann eine brauchbare Wissensmaschine, wenn die passenden Quellen, Berechtigungen und Ausführungsschritte dazu kommen.
Du hast einen Dokumentenbestand, in dem wichtige Informationen zwischen Text und Zeichnung versteckt sind? Die NOVA-Anwendungsfälle zeigen mögliche Einstiege. Für eine gemeinsame Prüfung genügt zunächst eine typische Frage mit dem zugehörigen freigegebenen Material; über die NOVA-Hauptseite lässt sich dieser erste Schritt besprechen.
Persönliches Gespräch gefällig?

Autor
Prof. Dr. Alexander Lutz, Professor für Big Data und KI an der FOM München, Doktor der Humangenetik und Anthropologie, ehemaliger Onlinespiele-Designer und natürlich Gründer und Inhaber der Agentur Die NEOs. Neben den Themen der künstlichen Intelligenz und deren Einsatzmöglichkeiten in der Praxis konzentriert sich Alexander auf die Kundenkommunikation. Neue Problemfelder oder technische Innovationen bereitet er so auf, dass der Nutzen für unsere Kunden deutlich wird. Er schläft zeitverantwortlich und agiert schnell, sein Motto: “Tue es, oder tue es nicht. Es gibt kein Versuchen.”
 Die NEOs – KI-generiert
 Die NEOs – KI-generiertNOVA am Modellprüfstand: Qwen3.6 35B gegen Qwen3.8 Distill