NOVA und Nemotron 3.5 Lightning: Ein Modell, das arbeiten will
Executive Summary
NVIDIA Nemotron 3.5 Lightning setzt auf eine für lokale Agenten relevante Arbeitsteilung: Rund 30 Milliarden Parameter stellen Modellkapazität bereit, etwa 3 Milliarden davon sind pro Token aktiv. Der Hersteller verbindet Mixture of Experts mit Mamba‑2 und Attention und richtet das Modell auf häufige Tool-Aufrufe und strukturierte Arbeitsschritte aus.
Für NOVA sehen wir darin einen Kandidaten für die Ausführungsschicht: Informationen zuordnen, Rückgaben prüfen und den nächsten Schritt vorbereiten. Unsere Windows-Umgebung mit einer RTX 5090 und 32 GB VRAM ist der vorgesehene Prüfstand. Ob eine konkrete Quantisierung mit dem benötigten Kontext vollständig im Grafikspeicher läuft, wird dort gemessen.
Der Nutzen für Unternehmen entsteht im gesamten Ablauf. Deshalb betrachten wir Lightning zusammen mit NOVA-Schnittstellen und einer passenden Modellauswahl. Herstellerangaben zur Geschwindigkeit sind dabei keine Messergebnisse unserer Installation.
Nemotron will arbeiten. Und zwar schnell.
Die Open-Weight-Welt macht gerade keine Pause. Kaum haben wir mit Gemma 4 gesehen, wie viel Intelligenz inzwischen in lokal beherrschbare Modellgrößen passt, legt NVIDIA mit einem Modell nach, das einen anderen Schwerpunkt setzt.
Nemotron 3.5 Lightning will arbeiten. Und zwar schnell.
Das ist für NOVA interessant. Denn bei produktiver lokaler KI zählt nicht nur, wie gut ein Modell grundsätzlich antworten kann. Mindestens ebenso wichtig ist die Frage: Wie viel dieser Leistung bekommen wir pro Sekunde, pro Watt und pro verfügbarer GPU tatsächlich in einen Unternehmensprozess?
Ein Agent verbringt einen großen Teil seiner Zeit mit ziemlich handfesten Aufgaben. Er wählt ein Werkzeug aus, verarbeitet dessen Rückgabe und bereitet Informationen für das nächste System vor. Gerade wenn solche Schritte häufig aufeinander folgen, entscheidet ihre Dauer darüber, ob ein Ablauf sich angenehm bedienen lässt. Genau an dieser Stelle wollen wir Lightning prüfen.
Warum wenig aktive Parameter nicht wenig Speicher bedeuten
Die technische Vorstellung von NVIDIA beschreibt Lightning als hybrides Modell aus Mamba‑2, Mixture of Experts und Attention. Die geringere aktive Parameterzahl kann den Rechenaufwand pro Token begrenzen. Die übrigen Experten verschwinden dadurch aber nicht aus dem Modell.
3 Milliarden aktive Parameter bedeuten nicht, dass nur ein 3B-Modell im Speicher liegt. Die gesamte Expertenstruktur muss weiter verfügbar sein. Diese Trennung von Modellkapazität und aktiver Rechenlast ist für unsere Planung wesentlich: Wir rechnen mit der tatsächlichen Datei und dem Speicherbedarf der Laufzeit, nicht mit einem vermeintlichen 3B-Footprint.
Noch schneller durch Multi-Token Prediction?
Lightning wurde mit Multi-Token Prediction trainiert. NVIDIA stellt außerdem Verfahren für spekulative Decodierung vor. Dabei werden mehrere mögliche Fortsetzungen vorgeschlagen und vom Zielmodell geprüft. Das kann die Ausgabe beschleunigen, benötigt aber eine passende Implementierung im Inferenz-Backend.
Ein Download oder ein neuer Modellname aktiviert dieses Verfahren nicht automatisch. Für unsere Ollama-Umgebung müssen Modellartefakt und unterstützter Ausführungspfad zusammenpassen. Den Betrieb ohne Beschleuniger messen wir getrennt von einer tatsächlich eingerichteten spekulativen Variante.
Geschwindigkeit allein genügt nicht
Ein sehr schnelles Modell, dessen Ausgaben anschließend ständig korrigiert werden müssen, macht einen Agenten nicht produktiver. Eine strukturierte Antwort muss dem vereinbarten Schema entsprechen. Ein Tool-Aufruf muss die richtige Funktion mit gültigen Parametern ansprechen.
Nicht jede Aufgabe braucht das größte verfügbare Modell. Sie braucht das für diese Aufgabe richtige Modell. In NOVA kann daraus eine gezielt eingerichtete Arbeitsteilung entstehen: ein Modell bereitet eine anspruchsvolle Analyse vor, ein anderes übernimmt wiederkehrende Verarbeitungsschritte. Ob Lightning diese Rolle erfüllt, prüfen wir an konkreten Aufgaben.
NOVA am Aufgabenverteiler
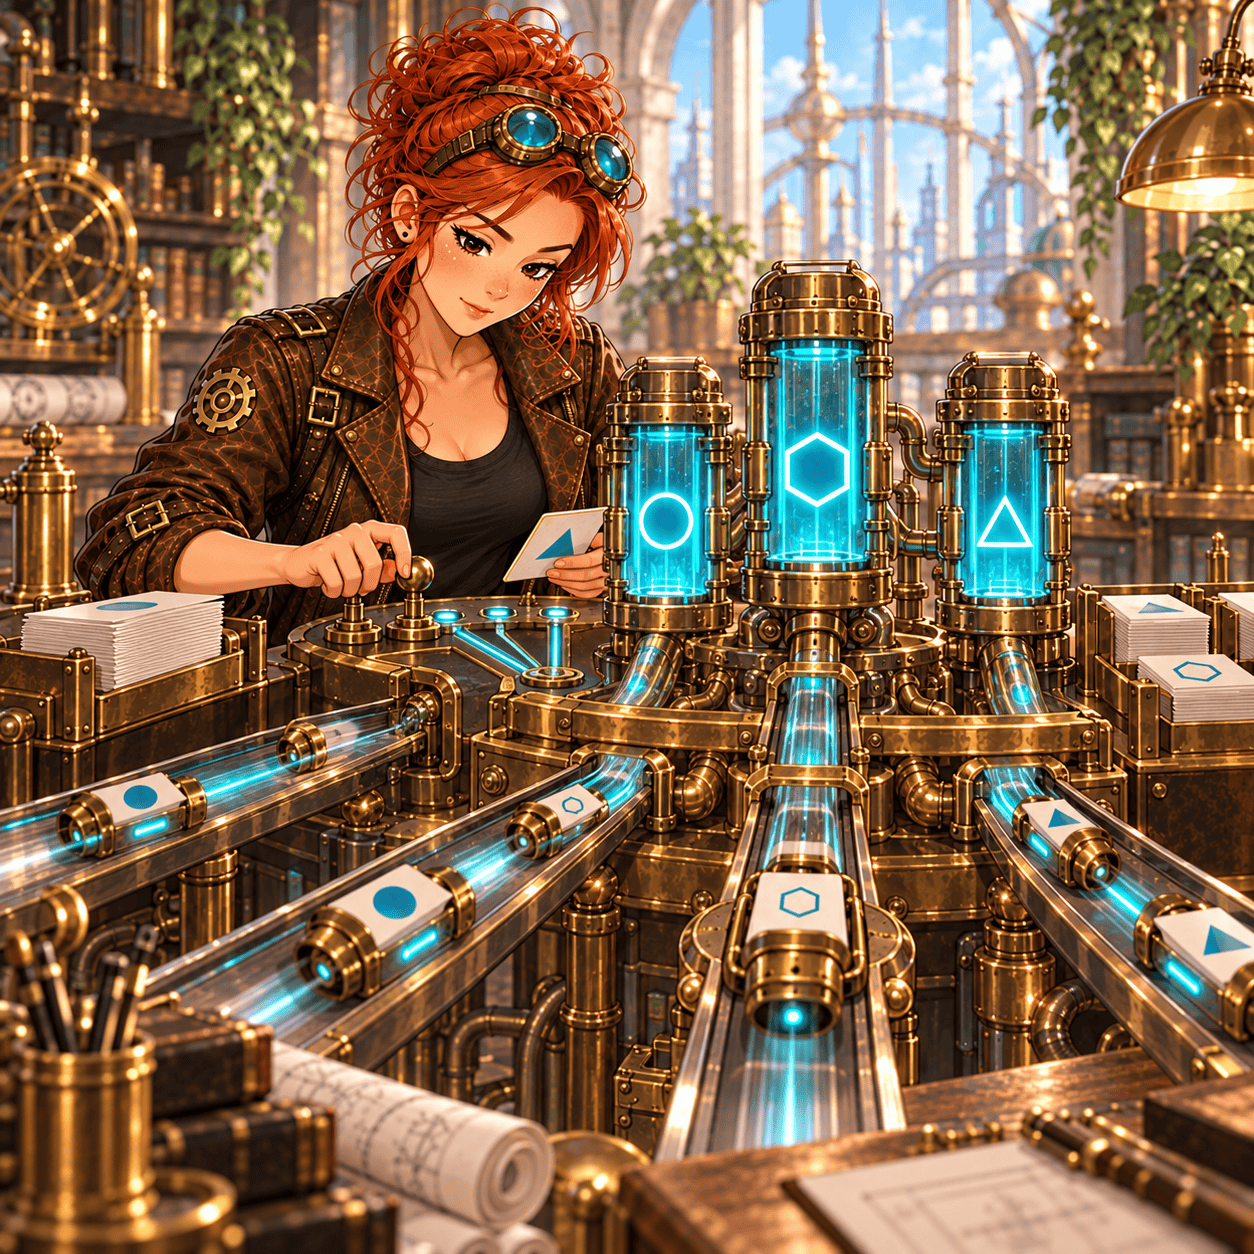
Stellen wir uns einen Servicevorgang vor. Eine Frage zu einem Produkt kommt an. NOVA soll das passende freigegebene Handbuch finden, eine relevante Passage zuordnen und einen Antwortvorschlag für das Team vorbereiten. In unserer Bildwelt bedient sie dafür den Aufgabenverteiler ihrer Wissensmaschine. Hinter jedem Anschluss steckt eine festgelegte Aufgabe.
Lightning wäre in diesem Szenario ein Kandidat für die kurzen, häufigen Verarbeitungsschritte. Das Modell könnte Suchergebnisse einordnen oder Informationen in eine definierte Struktur bringen. Die Suche nach Dokumenten übernimmt dabei das Wissenssystem; das Sprachmodell ersetzt nicht dessen Index. Wie Unterlagen vorbereitet und gefunden werden, erläutern wir im Bereich Wissen und RAG.
Und wenn der Vorschlag zurück in ein Serviceportal soll? Dann braucht es eine entwickelte Anbindung. Die NOVA-Integration über Schnittstellen legt fest, welche Informationen übergeben werden, was die Anwendung mit dem Ergebnis macht und wie sie einen fehlgeschlagenen Schritt erkennt.
Unsere RTX 5090 als Prüfstand
Unsere lokale Windows-Umgebung stellt eine NVIDIA GeForce RTX 5090 mit 32 GB VRAM bereit. NVIDIA nennt diese Karte als Plattform für lokale Lightning-Inferenz. Unsere Ollama-Modellliste weist eine rund 25 GB große Lightning-Datei aus; diese Dateigröße ist noch keine Messung des gesamten Grafikspeicherbedarfs.
Runtime, Kontextspeicher und weitere Komponenten kommen hinzu. Eine große nominelle Kontextlänge ist daher keine Zusage, dass derselbe Kontext auf einer einzelnen 32-GB-Karte nutzbar ist. Wir beginnen mit einem überschaubaren Kontext und steigern ihn anhand der tatsächlichen Aufgabe.
Für einen produktiven Wissensassistenten ist ohnehin selten das maximal mögliche Kontextfenster das Ziel. NOVA soll die relevanten Informationen bereitstellen. Eine gute Auswahl kann weniger Speicher verbrauchen und zugleich besser überprüfbare Antworten ermöglichen.
Was wir messen wollen
Zuerst zählt die Zeit bis zur ersten nutzbaren Antwort. Danach messen wir den Ausgabedurchsatz und den Spitzenbedarf im Grafikspeicher. Für Tool-Aufgaben protokollieren wir zusätzlich, ob das Ergebnis gültig war und wie viele Korrekturversuche nötig wurden.
Eigene Tokens-pro-Sekunde-Werte veröffentlichen wir erst nach einem reproduzierbaren Lauf. Quantisierung, Backend, Promptlänge, Cache und Parallelität gehören deshalb zu jedem Messprotokoll. Eine schnelle Herstellerdemo ist ein Anlass zum Testen; sie ersetzt diesen Test nicht.
Eine Komponente für die tatsächliche Aufgabe
Für NOVA sehen wir Lightning als mögliches Arbeitspferd. Es muss dabei nicht jede Denkaufgabe allein lösen. Sein Platz könnte dort sein, wo viele strukturierte Schritte anfallen und eine kurze Antwortzeit einen spürbaren Unterschied macht.
Das Aufgabenverteiler-Motiv erzählt genau diese Idee. Es zeigt keine fertige automatische Universalmaschine und keinen Screenshot unserer Installation, sondern eine Illustration der geplanten Arbeitsteilung.
Du möchtest wissen, ob so ein Ablauf zu eurem Unternehmen passt? Die NOVA-Anwendungsfälle geben konkrete Ausgangspunkte. Für die Umsetzung klären wir zuerst, welche Information benötigt wird, welche Aktion folgen darf und woran ihr ein brauchbares Ergebnis erkennt. Den passenden Einstieg findet ihr auf der NOVA-Hauptseite mit Kontaktformular.
Persönliches Gespräch gefällig?

Autor
Prof. Dr. Alexander Lutz, Professor für Big Data und KI an der FOM München, Doktor der Humangenetik und Anthropologie, ehemaliger Onlinespiele-Designer und natürlich Gründer und Inhaber der Agentur Die NEOs. Neben den Themen der künstlichen Intelligenz und deren Einsatzmöglichkeiten in der Praxis konzentriert sich Alexander auf die Kundenkommunikation. Neue Problemfelder oder technische Innovationen bereitet er so auf, dass der Nutzen für unsere Kunden deutlich wird. Er schläft zeitverantwortlich und agiert schnell, sein Motto: “Tue es, oder tue es nicht. Es gibt kein Versuchen.”
 KI-generierte Illustration für Die NEOs, erstellt mit OpenAI image_gen, Oktober 2026.
 Die NEOs – KI-generiertNOVA und Muse Glimmer 30B: Präzision für Code und Werkzeuge