Modelle und Benchmarks · Messlauf 1.–2. November 2026
Elf Embedding-Modelle im NOVA-Test: Warum der beste Suchhelfer nicht immer der größte ist
Executive Summary
EmbeddingGemma 300M erreicht in unserem erweiterten Suchtest die höchsten Werte bei deutschen Kurztexten, beim direkten Sprachwechsel zwischen Deutsch und Englisch und bei der Suche in Dokumentabschnitten. Qwen3-Embedding 4B liegt dagegen im getrennten Ganzdokument-Test vorne: In allen zwölf Längen- und Positionsblöcken steht die richtige Dokumentfassung an erster Stelle.
Elf lokal ausgeführte Modelle, drei Wiederholungen und 528 Blockergebnisse bilden die Grundlage. Die Daten sind synthetisch und kontrolliert. Unsere Ergebnisse helfen bei der Auswahl für ähnliche Aufgaben; sie erklären kein Modell zum universellen Sieger.
NOVA am Embedding-Prüfstand nach dem Nachtlauf. KI-generierte Illustration, kein Messfoto.
Der Rechner lief über Nacht. Die eigentliche Frage blieb dieselbe.
In unserem ersten Vergleich von 21 lokalen KI-Modellen ging es um Textaufgaben, Belege und eine kleine Suchprüfung. Drei Embedder sollten damals 60 Dokumente mit 36 Suchanfragen erschließen. Für einen ersten Eindruck war das brauchbar. Für die Auswahl der Suchkomponente in NOVA wollte ich genauer hinsehen.
Denn was hilft das beste Antwortmodell, wenn es die falsche Passage vorgelegt bekommt? Bevor NOVA eine Antwort formuliert, muss die Suche die passende Information finden. Ein Embedding-Modell übersetzt dafür Texte und Fragen in Zahlenvektoren. Unser Test endet bei der Rangfolge der Fundstellen. Er bewertet keine formulierte Antwort.
Diesmal lief der Ryzen vom 1. auf den 2. November. Die Testschleife mit Ladezeiten und vorgesehenen Pausen dauerte rund 16 Stunden und 18 Minuten; der abschließende Berichtsexport kam hinzu. Das Ergebnis ist umfangreicher als eine neue Bestenliste: Es zeigt, wie stark die Wahl des Suchverfahrens die Modellwahl verändert.
Was wir diesmal genauer wissen wollten
Im deutschen Teil treten sinngleiche Formulierungen, zusammengesetzte Wörter, Verneinungen, Zahlen, Namen und Tippfehler auf. 180 Fragen stehen 600 Passagen gegenüber. Im Sprachtest suchen wir in beide Richtungen zwischen Deutsch und Englisch. Dazu kommen einsprachige Suchaufgaben und gemischte Bestände: insgesamt 360 Fälle in sechs gleich großen Gruppen.
Für lange Dokumente gibt es zwei getrennte Versuche. Im ersten teilen wir 120 Dokumente mit 2.000 bis 12.000 Wörtern in 9.750 Abschnitte auf. Jeder Abschnitt enthält bis zu 120 Wörter, benachbarte Abschnitte überlappen sich um 40 Wörter. 120 Fragen prüfen, ob die relevante Passage wiedergefunden wird.
Im zweiten Versuch bleibt jedes Dokument als Ganzes erhalten. Vier Längen von 300 bis 6.000 Wörtern und drei Positionen der entscheidenden Information ergeben zwölf Blöcke. Zu jeder gültigen Fassung gibt es einen ähnlich formulierten, ausdrücklich veralteten Gegenkandidaten. Dieser Versuch prüft die Unterscheidung ganzer Dokumentfassungen. Er verwendet andere Texte als der Abschnittstest und ist deshalb kein direkter Beweis, dass eine der beiden Strategien grundsätzlich besser wäre.
Mit dem bisherigen Kern ergeben sich 1.056 vorgesehene Suchfälle je Modell und Runde. Alle elf Modelle haben ihre Funktionsprüfung bestanden. Sämtliche 528 Blockergebnisse sind vorhanden; 207 dokumentieren eine Kontextüberschreitung. Dort gibt es keinen Qualitätswert und auch keine ersatzweise Null.
Die erste Überraschung: Ein kleines Modell findet die richtigen Passagen
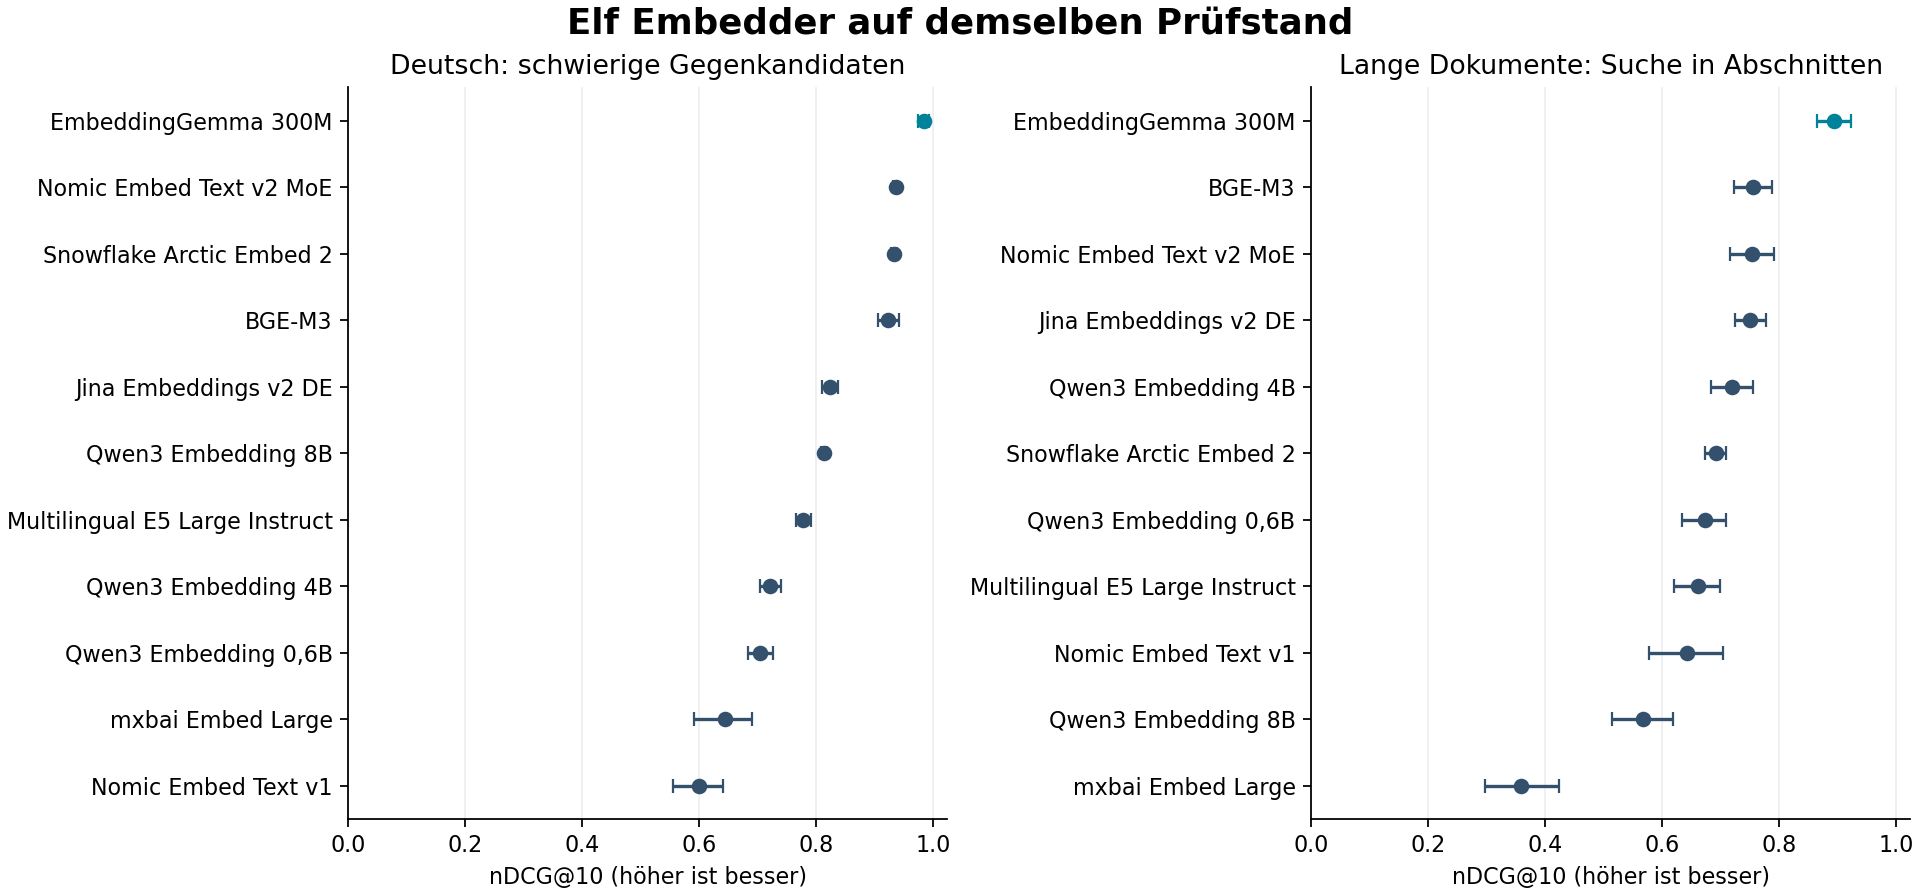
Die folgende Tabelle zeigt nDCG@10. Der Wert berücksichtigt, ob relevante Treffer weit vorne stehen; 1,000 ist die ideale Reihenfolge. Ein Wert von 0,986 bedeutet nicht, dass 98,6 Prozent beliebiger Kundenfragen richtig beantwortet werden. DE → EN bezeichnet eine deutsche Frage in einem englischen Kandidatenbestand, EN → DE die Gegenrichtung.
| Modell | Deutsch | DE → EN | EN → DE | Lange Dokumente als Abschnitte |
|---|---|---|---|---|
| EmbeddingGemma 300M | 0,986 | 1,000 | 0,988 | 0,895 |
| Nomic Embed Text v2 MoE | 0,936 | 0,705 | 0,938 | 0,753 |
| Snowflake Arctic Embed 2 | 0,934 | 0,822 | 0,938 | 0,692 |
| BGE-M3 | 0,924 | 0,840 | 0,764 | 0,756 |
| Jina Embeddings v2 DE | 0,824 | 0,755 | 0,754 | 0,750 |
| Qwen3 Embedding 8B | 0,814 | 0,769 | 0,834 | 0,567 |
| Multilingual E5 Large Instruct | 0,779 | 0,926 | 0,982 | 0,661 |
| Qwen3 Embedding 4B | 0,721 | 0,844 | 0,797 | 0,719 |
| Qwen3 Embedding 0,6B | 0,705 | 0,899 | 0,729 | 0,674 |
| mxbai Embed Large | 0,645 | 0,551 | 0,589 | 0,360 |
| Nomic Embed Text v1 | 0,600 | 0,506 | 0,648 | 0,643 |
Gleiche Suchfälle innerhalb jeder Spalte, drei vollständige Wiederholungen. Höher ist besser. Die Sprachrichtungen enthalten je 60 Fälle; die Deutsch- und Abschnittstests 180 beziehungsweise 120. Der Herkunftsfilter beschreibt Entwicklungszuordnung, keine Eigentums- oder Souveränitätsgarantie.
EmbeddingGemma liegt im Deutschtest bei 0,986. Die richtige Passage steht bei 173 der 180 Fragen an erster Stelle; innerhalb der ersten fünf Treffer wird sie bei allen gefunden. Bei fünf der sechs deutschen Teilgruppen erreicht das Modell die ideale Rangfolge. Zahlen und Fristen bleiben auch hier die schwierigere Disziplin.
Nomic v2 MoE, Snowflake Arctic Embed 2 und BGE-M3 folgen. Der Abstand zwischen Nomic und Snowflake ist im Deutschtest so klein, dass unser gepaarter Unsicherheitsvergleich keine klare Reihenfolge trägt. Die drei Nachkommastellen sollen Unterschiede sichtbar machen, keine Gewissheit vortäuschen.
Deutsch und Englisch: Eine einzige Sprachzahl würde etwas verdecken
EmbeddingGemma erreicht bei deutschen Fragen an englische Texte 1,000 und in der Gegenrichtung 0,988. E5 Large Instruct fällt als weiterer Kandidat auf: 0,926 und 0,982 sind deutlich stärker als sein Ergebnis im deutschen Gegenkandidatentest.
Aber E5 verliert im gemischten deutsch-englischen Kandidatenbestand: Dort liegen die Werte bei 0,495 für deutsche und 0,662 für englische Fragen. In diesen Gruppen dürfen passende Fassungen beider Sprachen gefunden werden. Eine feste Zielsprache erleichtert dem Modell unsere Aufgabe offenbar stärker als der gemeinsame Bestand.
Auch die Richtung zählt. Nomic v2 MoE erreicht 0,705 für DE → EN und 0,938 für EN → DE. Das Etikett »mehrsprachig« ersetzt deshalb keinen Test mit den Sprachen und Beständen, die im Unternehmen tatsächlich vorkommen.
Ganze Dokumente erzählen eine andere Geschichte
Qwen3-Embedding 4B findet in unserem Ganzdokument-Test für alle 360 Fälle die gültige Fassung auf Rang eins, in jeder der drei Runden. Das gilt für 300, 1.000, 3.000 und 6.000 Wörter und jeweils für Informationen am Anfang, in der Mitte und am Ende. Die Varianten mit 0,6B und 8B verarbeiten ebenfalls alle vorgesehenen Längen, ordnen aber nicht jede Fassung ideal ein.
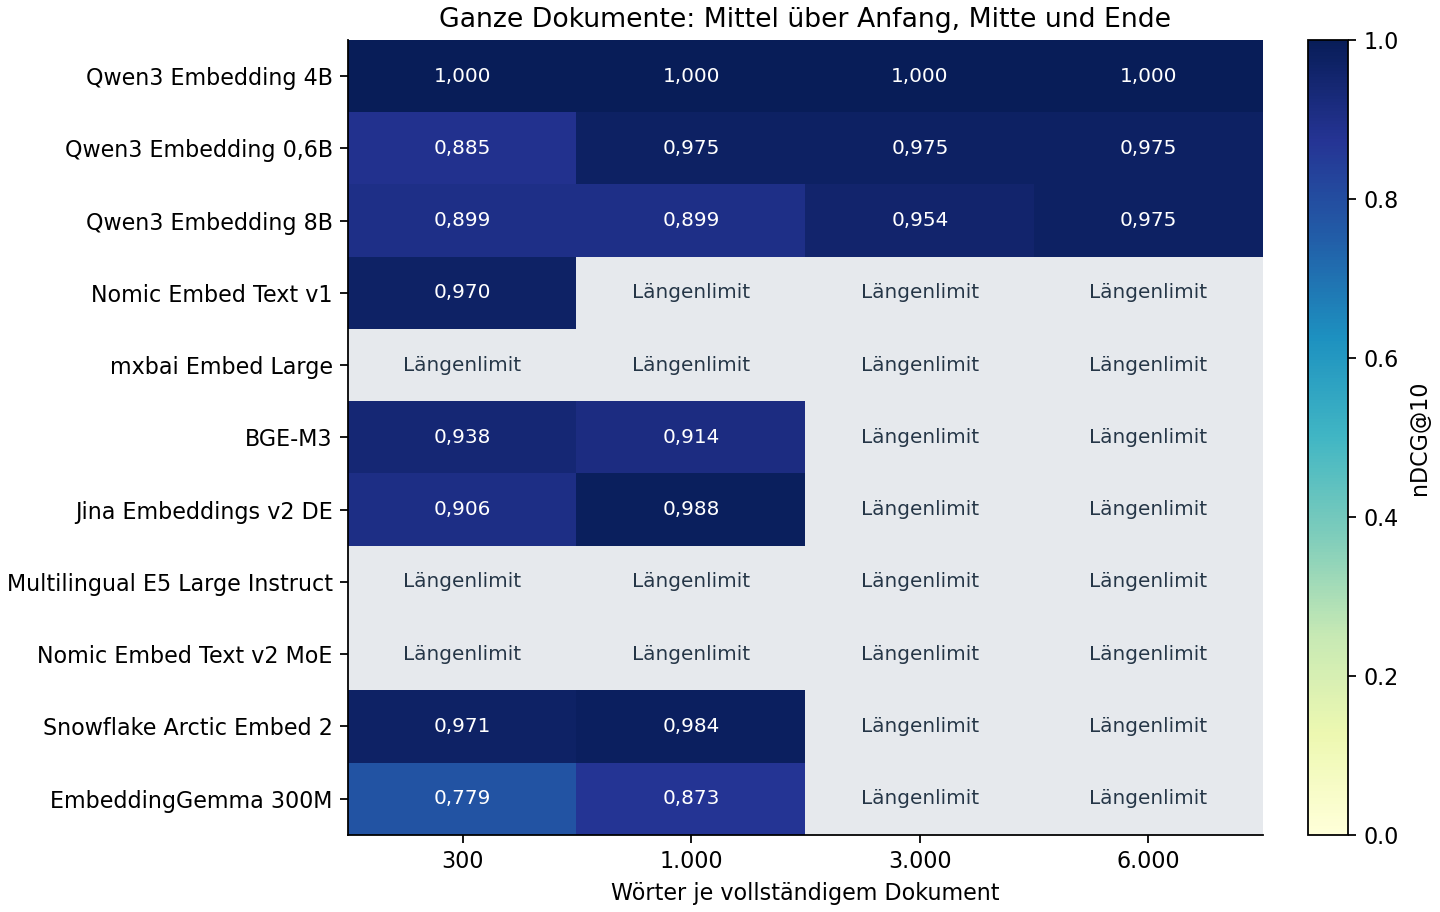
EmbeddingGemma kommt bei den vollständigen 300-Wörter-Dokumenten im Mittel nur auf 0,779. Bei 1.000 Wörtern sind es 0,873; die längeren Blöcke passen nicht in die getestete Konfiguration. Das widerspricht dem guten Abschnittsergebnis nicht. Ein kompakter Suchvektor für eine Passage muss etwas anderes leisten als ein Vektor für ein langes Dokument mit einer kleinen entscheidenden Statusangabe.
Ein Beispiel macht das greifbar: Das synthetische Handbuch »Aster, Ausgabe 99« enthält eine gültige Wiederherstellungsfrist von 24 Stunden und einen verworfenen Entwurf mit sechs Stunden. Die Frage verlangt ausdrücklich die aktuelle Regel. EmbeddingGemma setzt im 300-Wörter-Block mit der Regel am Anfang den alten Entwurf vor die gültige Fassung. Qwen3 4B ordnet dasselbe Paar richtig ein.
Die praktische Folgerung reicht über die Modellwahl hinaus: Gültigkeit und Versionsstand sollten nach Möglichkeit als Metadaten geführt und bei der Suche berücksichtigt werden. Ein semantisch ähnlicher Entwurf bleibt semantisch ähnlich, auch wenn er nicht mehr gelten darf. Einen solchen Metadatenfilter haben wir hier nicht mitgemessen.
Für die Suche in Abschnitten ist EmbeddingGemma wieder vorne
Über die 9.750 Abschnitte erreicht EmbeddingGemma 0,895 nDCG@10. BGE-M3, Nomic v2 MoE und Jina v2 DE liegen mit rund 0,756, 0,753 und 0,750 dicht beieinander. Aus diesen kleinen Abständen allein würde ich keine feste Rangfolge für eine Kundeninstallation ableiten.
Bewerten wir das richtige Ursprungsdokument statt der exakten Passage, steigt EmbeddingGemma auf 0,922. Bei Nomic v1 unterscheiden sich diese Ebenen besonders: 0,643 für die Passage stehen 0,885 für das Ursprungsdokument gegenüber. Das Modell findet also oft das richtige Dokument, aber nicht den am besten passenden Abschnitt. Für eine präzise Quellenangabe ist dieser Unterschied erheblich.
Tempo und Speicher gehören daneben, nicht in denselben Punktetopf
Im deutschen Kurztextblock benötigt Jina v2 DE für eine Frage im Median rund 16,4 Millisekunden, EmbeddingGemma 19,9 Millisekunden. Beim Einlesen derselben Passagen mit acht Texten je Anfrage verarbeitet Nomic v2 MoE durchschnittlich rund 125 Passagen pro Sekunde; EmbeddingGemma rund 89. Das sind Werte unseres lokalen Prüfstands, keine Laufzeitzusagen für andere Rechner.
Gemessen wird die jeweilige HTTP-Anfrage an Ollama. Die absichtliche Pause von 300 Millisekunden vor neuen Anfragen, Identitätsprüfungen und die anschließende Vektorsuche sind darin nicht enthalten. Der gesamte Testdurchlauf dauert entsprechend länger. Auch das Indexierungstempo ist an Textlänge und Batchgröße gebunden.
Die Vektordimension wirkt sich unabhängig von der Modellgröße auf den Suchindex aus. Eine Million Vektoren mit 768 Float32-Werten benötigen rechnerisch rund 2,86 GiB Nutzdaten. Mit 4.096 Dimensionen sind es 15,26 GiB. Texte, Metadaten und Indexstrukturen kommen hinzu. Unser Test nutzt native Dimensionen; eine reduzierte Ausgabe haben wir nicht verglichen.
Europäischer Ursprung ist eine andere Frage als lokale Ausführung
Jina v2 DE ist im Test der Kandidat mit deutschem Entwicklungsursprung. Die Modellkarte weist Apache 2.0 aus. Jina AI gehört seit Oktober 2025 zu Elastic. Für eine Herkunftstabelle müssen wir deshalb Entwicklungsursprung, heutige Unternehmenszugehörigkeit, Basismodell und Lizenz getrennt erfassen. Ein einziges Fähnchen wäre zu grob. Quellen: Jina v2 DE: Modellkarte und Apache‑2.0‑Lizenz; Jina AI: Zugehörigkeit zu Elastic.
Alle elf getesteten Modelle laufen hier lokal über Ollama. Daraus folgt weder eine europäische Eigentümerstruktur noch eine Aussage über die komplette NOVA-Datenverarbeitung. Bei EmbeddingGemma gelten die eigenen Gemma-Nutzungsbedingungen; es ist nicht pauschal mit einer Apache- oder MIT-Veröffentlichung gleichzusetzen. EmbeddingGemma: Modellkarte, Präfixe und Gemma-Nutzungsbedingungen.
Mistral Embed erhielt in diesem lokalen Vergleich keinen Messwert. Die offizielle Dokumentation beschreibt das API-Angebot; eine für diesen Lauf bestätigte lokale Ollama-Gewichtsveröffentlichung lag uns nicht vor. Die geprüfte deepset-Konvertierung blieb wegen ihres dokumentierten Ladefehlers ebenfalls draußen. Beides ist eine Lücke in der Kandidatenauswahl, kein Beleg für schlechte Suchqualität. Mistral Embed: offizielle Modellbeschreibung und API-Angebot.
Welche Modelle würde ich für NOVA als Nächstes einsetzen?
Für die Suche in kurzen deutschen oder deutsch-englischen Abschnitten wäre EmbeddingGemma mein erster Kandidat für einen Test mit echten Unternehmensfragen. Die Qualität dieses Datensatzes, die kompakte Modelldatei und 768 Dimensionen passen gut zu diesem Einsatz. Die Lizenz und die tatsächlich unterstützten Eingabelängen gehören zur Auswahl dazu.
Wenn ganze längere Dokumente als einzelne Vektoren erschlossen werden sollen, würde ich Qwen3-Embedding 4B zuerst prüfen. Sein Ergebnis rechtfertigt diesen nächsten Versuch, keine pauschale Garantie für beliebige Handbücher. Seine höhere Latenz und größere Vektoren stehen im selben Vergleich mit auf dem Tisch.
Bei einer Vorgabe für europäische Entwicklungsherkunft bleibt Jina v2 DE ein konkret gemessener Kandidat. Wo Apache 2.0 und schnelles Einlesen kurzer Abschnitte ausschlaggebend sind, ist Nomic v2 MoE interessant. Snowflake Arctic Embed 2 und BGE-M3 sollten als Vergleichskandidaten erhalten bleiben; E5 insbesondere für feste deutsch-englische Suchrichtungen.
Was unser Test offenlässt
Die Fragen stammen aus kontrollierten synthetischen Themenfamilien. Viele Fälle teilen sich Sprachmuster. Sie bilden weder die Breite realer Unternehmen noch ein unabhängiges MTEB-Ergebnis ab. Die drei Wiederholungen bestätigen hier stabile nDCG-Werte der vier gemeinsamen Bereiche; sie erzeugen keine neuen fachlich unabhängigen Testfragen.
Wir haben konkrete Ollama-Pakete mit ihren dokumentierten Quantisierungen untersucht. Die Qwen-Varianten liegen beispielsweise nicht alle in derselben Quantisierung vor. Ein größeres Modell kann durch andere Präzision, Präfixe oder eine andere Runtime anders abschneiden. Unsere Funktionsprüfung bestätigt korrekte Dimensionen, Wiederholbarkeit und eine einfache Suchaufgabe; sie beweist keine vollständige Gleichwertigkeit mit der ursprünglichen Herstellerimplementierung.
Die Suche nutzt ausschließlich dichte Vektoren und exakte Kosinusähnlichkeit. Hybridsuche, Reranker, OCR, Antwortgenerierung und Berechtigungsprüfung fehlen in diesem Versuch. Gerade bei BGE-M3 ist das nur ein Teil der verfügbaren Methoden. Im nächsten Praxisschritt brauchen wir echte Fragen, verlässliche Dokumentversionen und geprüfte Fundstellen. Erst damit lässt sich entscheiden, welcher Suchhelfer in der jeweiligen NOVA-Installation bleiben soll.
Im ersten Benchmark war die Embedding-Prüfung ein kleiner Teil eines großen Modellvergleichs. Jetzt ist sichtbar, warum sie einen eigenen Test verdient: Die richtige Entscheidung beginnt mit der Frage, welche Art von Fundstelle wir eigentlich brauchen.
Messgrundlage und technische Vertiefung
Eigene Messungen mit NEOs-Embedding-Suite 2.1, Lauf vom 1.–2. November 2026. Tabellen und Grafiken stammen aus dem vollständigen Rückgabepaket. Methodik, Modellvarianten, Kontextkonfiguration und vollständige Detailtabellen dokumentieren die Auswertung.
Herstellerangaben sind von den eigenen Messwerten getrennt: Qwen3 Embedding: Modellkarte und Apache‑2.0‑Lizenz · Nomic v2 MoE: Modellkarte, Präfixe und 512-Token-Kontext · Snowflake Arctic Embed 2: Modellkarte · BGE-M3: Modellkarte und MIT-Lizenz · E5 Large Instruct: Modellkarte und MIT-Lizenz.
Methodik, Modellvarianten und vollständige Detailtabellen anzeigen
Messlauf 1.–2. November 2026. Alle folgenden Ergebniswerte stammen aus dem Rückgabepaket des Ryzen-Prüfstands; Quellenangaben zu Modellen wurden am 2. November geprüft.
Vollständigkeit und Grenzen der Prüfung
Elf erfolgreiche Vorprüfungen, 528 eindeutige Modell-/Block-/Rundenkombinationen. 321 Blöcke vollständig, 207 mit erwarteter Kontextüberschreitung. 86.076 erfolgreiche gespeicherte Anfragen, 207 mit Kontextüberschreitung, keine sonstigen finalen Anfragestatus. Erfolgreiche Haupt-Query-Messungen: 28.638; weitere 22 Query-Aufrufe stammen aus den Vorprüfungen. Jeder erfolgreiche Vektoraufruf meldet die erwartete Dimension.
Beginn 1. November 16:06:13 Uhr MEZ, Ende der Testschleife 2. November 08:24:09 Uhr MEZ, Abschluss des Starters mit Rückgabe 09:04:56 Uhr MEZ. Die Testschleife umfasst Pausen, Laden, Prüfen, Embedding und Suche. Der abschließende Berichtsexport dauert zusätzlich rund 41 Minuten.
Die Rückgabe enthält Ranglisten und Anfragekennzahlen, keine Float32-Vektordateien. Rangmetriken lassen sich daraus nachrechnen; eine unabhängige Prüfung der tatsächlichen Vektoren, Pooling-Parität oder GPU-Kernel erfolgt nicht. Alle 28.638 Haupt-Ranglisten wurden zusätzlich mit einer separaten Python-Implementierung bewertet. Die 3.050 verglichenen nDCG‑, MRR‑, Recall- und Eltern-Dokument-Kennzahlen stimmen bis auf Rundungsreste überein (maximale Abweichung 2,6 × 10⁻¹⁵). Die nDCG-Werte sind über die drei Runden in diesen Bereichen gleich.
Aufgaben und Suchverfahren
| Block | Dokumente / Abschnitte | Fragen je Runde | Angeforderter Kontext / Batch |
|---|---|---|---|
| legacy | 60 | 36 | 2048 Tokens / 8 |
| de | 600 | 180 | 2048 Tokens / 8 |
| cross | 600 | 360 | 2048 Tokens / 8 |
| long-chunks | 9750 | 120 | 2048 Tokens / 8 |
| whole-300-Anfang | 60 | 30 | 2048 Tokens / 1 |
| whole-300-Ende | 60 | 30 | 2048 Tokens / 1 |
| whole-300-Mitte | 60 | 30 | 2048 Tokens / 1 |
| whole-1000-Anfang | 60 | 30 | 4096 Tokens / 1 |
| whole-1000-Ende | 60 | 30 | 4096 Tokens / 1 |
| whole-1000-Mitte | 60 | 30 | 4096 Tokens / 1 |
| whole-3000-Anfang | 60 | 30 | 16384 Tokens / 1 |
| whole-3000-Ende | 60 | 30 | 16384 Tokens / 1 |
| whole-3000-Mitte | 60 | 30 | 16384 Tokens / 1 |
| whole-6000-Anfang | 60 | 30 | 32768 Tokens / 1 |
| whole-6000-Ende | 60 | 30 | 32768 Tokens / 1 |
| whole-6000-Mitte | 60 | 30 | 32768 Tokens / 1 |
Der angeforderte Kontext wird durch die modellbezogene Konfiguration begrenzt. Eingaben werden mit truncate=false verarbeitet. Eine Kontextüberschreitung eines Kandidaten stoppt den betreffenden Block; keine Rangliste aus verkleinertem Korpus. Gemeinsame kurze Blöcke, vollständige Dokumente und Eltern-Dokumentwertung werden getrennt ausgewiesen. Keine ANN-Näherung, ausschließlich exakte Kosinus-Suche und Top 10; keine Reranker und keine Hybridwertung.
Getestete Modellvarianten
| Ollama-Modellkennung | Quantisierung | Dimensionen | Modelldatei GB | Digest-Präfix | Lizenz laut Modellkarte |
|---|---|---|---|---|---|
| nomic-embed-text:latest | F16 | 768 | 0,274 | 0a109f422b47 |
Apache‑2.0 |
| mxbai-embed-large:latest | F16 | 1024 | 0,670 | 468836162de7 |
Apache‑2.0 |
| qwen3-embedding:8b | Q4_K_M | 4096 | 4,677 | 64b933495768 |
Apache‑2.0 |
| qwen3-embedding:0.6b | Q8_0 | 1024 | 0,639 | ac6da0dfba84 |
Apache‑2.0 |
| qwen3-embedding:4b | Q4_K_M | 2560 | 2,497 | df5bd2e3c74c |
Apache‑2.0 |
| bge-m3:latest | F16 | 1024 | 1,158 | 790764642607 |
MIT |
| jina/jina-embeddings-v2-base-de:latest | F16 | 768 | 0,323 | f9b10d7e24af |
Apache‑2.0 |
| blaifa/multilingual-e5-large-instruct:Q8_0 | Q8_0 | 1024 | 0,603 | 6bc3b519b1c2 |
MIT |
| nomic-embed-text-v2-moe:latest | F16 | 768 | 0,958 | ff9c2f10ef5e |
Apache‑2.0 |
| snowflake-arctic-embed2:latest | F16 | 1024 | 1,160 | 5de93a84837d |
Apache‑2.0 |
| embeddinggemma:300m | BF16 | 768 | 0,622 | 85462619ee72 |
Gemma terms |
GB = 10⁹ Bytes, GiB = 2³⁰ Bytes. Modellgröße ist kein Arbeitsspeicherbedarf. Herkunftsfelder wurden nicht neu aus Nationalitätsnamen abgeleitet: Jina deutscher Ursprung, heute Elastic; Qwen/Alibaba und BAAI China; Google, Nomic und Snowflake USA; E5 und Mixedbread international zugeordnet. Diese Entwicklerzuordnung ist keine Aussage zur Herkunft sämtlicher Basismodelle, Trainingsdaten oder Konzernkontrolle.
Präfixe und Modellkontext
| Modell | Query-Präfix | Dokument-Präfix | Konfiguriertes Maximum |
|---|---|---|---|
| Nomic Embed Text v1 | search_query: |
search_document: |
8192 |
| mxbai Embed Large | Represent this sentence for searching relevant passages: |
(leer) |
512 |
| Qwen3 Embedding 8B | Instruct: Given a web search query, retrieve relevant passages that answer the query |
(leer) |
32768 |
| Qwen3 Embedding 0,6B | Instruct: Given a web search query, retrieve relevant passages that answer the query |
(leer) |
32768 |
| Qwen3 Embedding 4B | Instruct: Given a web search query, retrieve relevant passages that answer the query |
(leer) |
32768 |
| BGE-M3 | (leer) |
(leer) |
8192 |
| Jina Embeddings v2 DE | (leer) |
(leer) |
8192 |
| Multilingual E5 Large Instruct | Instruct: Given a web search query, retrieve relevant passages that answer the query |
(leer) |
512 |
| Nomic Embed Text v2 MoE | search_query: |
search_document: |
512 |
| Snowflake Arctic Embed 2 | query: |
(leer) |
8192 |
| EmbeddingGemma 300M | task: search result | query: |
title: none | text: |
2048 |
Deutsch nach Teilgruppe
| Modell | Paraphrase | Komposita | Verneinung | Zahlen | Namen | Tippfehler |
|---|---|---|---|---|---|---|
| EmbeddingGemma 300M | 1,000 | 1,000 | 1,000 | 0,914 | 1,000 | 1,000 |
| Nomic Embed Text v2 MoE | 1,000 | 0,988 | 1,000 | 0,631 | 1,000 | 1,000 |
| Snowflake Arctic Embed 2 | 1,000 | 0,975 | 1,000 | 0,631 | 1,000 | 1,000 |
| BGE-M3 | 0,840 | 0,951 | 1,000 | 0,828 | 0,926 | 1,000 |
| Jina Embeddings v2 DE | 0,631 | 0,975 | 1,000 | 0,633 | 0,705 | 1,000 |
| Qwen3 Embedding 8B | 0,643 | 0,631 | 1,000 | 0,624 | 1,000 | 0,988 |
| Multilingual E5 Large Instruct | 0,988 | 0,631 | 0,631 | 0,631 | 0,926 | 0,865 |
| Qwen3 Embedding 4B | 0,631 | 0,668 | 0,963 | 0,631 | 0,631 | 0,803 |
| Qwen3 Embedding 0,6B | 0,742 | 0,548 | 0,742 | 0,603 | 0,631 | 0,963 |
| mxbai Embed Large | 0,388 | 0,586 | 0,903 | 0,560 | 0,811 | 0,623 |
| Nomic Embed Text v1 | 0,320 | 0,562 | 0,988 | 0,521 | 0,319 | 0,892 |
Sprachwechsel und gemischte Bestände
| Modell | DE → EN | EN → DE | DE → MIX | EN → MIX | Direkter Sprachwechsel, Mittel |
|---|---|---|---|---|---|
| EmbeddingGemma 300M | 1,000 | 0,988 | 0,921 | 0,941 | 0,994 |
| Multilingual E5 Large Instruct | 0,926 | 0,982 | 0,495 | 0,662 | 0,954 |
| Snowflake Arctic Embed 2 | 0,822 | 0,938 | 0,833 | 0,858 | 0,880 |
| Nomic Embed Text v2 MoE | 0,705 | 0,938 | 0,890 | 0,704 | 0,822 |
| Qwen3 Embedding 4B | 0,844 | 0,797 | 0,733 | 0,819 | 0,820 |
| Qwen3 Embedding 0,6B | 0,899 | 0,729 | 0,727 | 0,802 | 0,814 |
| BGE-M3 | 0,840 | 0,764 | 0,901 | 0,844 | 0,802 |
| Qwen3 Embedding 8B | 0,769 | 0,834 | 0,755 | 0,763 | 0,802 |
| Jina Embeddings v2 DE | 0,755 | 0,754 | 0,785 | 0,742 | 0,754 |
| Nomic Embed Text v1 | 0,506 | 0,648 | 0,432 | 0,572 | 0,577 |
| mxbai Embed Large | 0,551 | 0,589 | 0,386 | 0,530 | 0,570 |
Je Richtung 60 Fälle, im Mittel der direkten Richtungen gleich gewichtet. Der vollständige Cross-Block enthält zusätzlich DE-DE und EN-EN; sein Gesamtwert ist deshalb kein reiner Sprachwechselwert. In MIX gelten deutsche und englische Fassungen als mögliche relevante Treffer; der durchschnittliche Recall hat dort einen anderen Nenner als in der festen Zielsprache.
Ressourcen im deutschen Kurztextblock
| Modell | Query Median ms | Query p95* ms | Passagen/s bei Batch 8 | Max. gemeldete VRAM-Residenz GiB | 1 Mio. Float32-Vektoren GiB |
|---|---|---|---|---|---|
| Nomic Embed Text v1 | 15,8 | 20,1 | 124,2 | 0,313 | 2,86 |
| Jina Embeddings v2 DE | 16,4 | 21,3 | 110,2 | 0,313 | 2,86 |
| EmbeddingGemma 300M | 19,9 | 24,9 | 89,5 | 0,639 | 2,86 |
| Nomic Embed Text v2 MoE | 20,4 | 29,0 | 125,1 | 0,549 | 2,86 |
| Multilingual E5 Large Instruct | 22,7 | 30,2 | 79,8 | 0,318 | 3,81 |
| Qwen3 Embedding 0,6B | 23,6 | 33,3 | 84,7 | 0,918 | 3,81 |
| BGE-M3 | 24,9 | 34,6 | 74,5 | 0,642 | 3,81 |
| Qwen3 Embedding 8B | 25,0 | 83,9 | 52,8 | 5,045 | 15,26 |
| Snowflake Arctic Embed 2 | 25,5 | 34,7 | 75,7 | 0,642 | 3,81 |
| mxbai Embed Large | 33,5 | 35,1 | 77,8 | 0,582 | 3,81 |
| Qwen3 Embedding 4B | 48,1 | 80,2 | 62,4 | 2,910 | 9,54 |
*p95 ist das 95. Perzentil der pro Frage über drei Runden ermittelten Medianzeiten. Es ist kein Service-p95 über sämtliche Einzelaufrufe. Query-Walltime umfasst die HTTP-Anfrage, nicht die vorgeschaltete 300-ms-Pause, Modellprüfungen oder Vektorsuche. Passagen/s ist das arithmetische Mittel erfolgreicher Batch-Durchsätze derselben Textsammlung. GPU-Residenz stammt aus Ollama /api/ps und ist weder ein allgemeines Hardwareminimum noch die Gesamtbelegung anderer Prozesse. Keine Übertragung auf CPU‑, Laptop- oder Mehrbenutzerbetrieb.
Unsicherheit und mögliche Rangfolgen
nDCG@10 verwendet den Gain 2^Relevanzgrad − 1 und logarithmischen Positionsabschlag. MRR@10 wertet den ersten relevanten Treffer, Recall@k den Anteil gefundener relevanter Kandidaten. In vielen kurzen Fällen gibt es genau einen positiven Kandidaten. In den Absatztests lässt sich Dokumentqualität separat nach maximaler Abschnittsähnlichkeit und Eltern-ID zusammenfassen. nDCG ist keine Antwortgenauigkeit.
Wiederholungen werden pro Frage vor der Auswertung zusammengefasst. 1.000 Bootstrap-Stichproben werden über Themenfamilien gezogen, Seed 20261015; die gemeinsamen erweiterten Blöcke haben je 30 Familien, der alte Kern zwölf. Gepaarte Modellvergleiche verwenden dieselben Fragen und Familien. Die Intervalle sind explorativ, ohne Korrektur für alle möglichen Mehrfachvergleiche. Gemeinsame Textschablonen und fehlende unabhängige menschliche Relevanzprüfung können systematische Verzerrungen erzeugen, die diese Intervalle nicht abbilden.
| Vergleich | Block | Differenz nDCG | 95%-Intervall |
|---|---|---|---|
| Nomic Embed Text v2 MoE minus Snowflake Arctic Embed 2 | de | 0,0021 | -0,0041 bis 0,0103 |
| BGE-M3 minus Jina Embeddings v2 DE | long-chunks | 0,0059 | -0,0422 bis 0,0491 |
| EmbeddingGemma 300M minus Multilingual E5 Large Instruct | cross | 0,0400 | 0,0154 bis 0,0707 |
Gesamtdokumente: alle Positionen getrennt
| Modell | 300 / Anfang | 300 / Mitte | 300 / Ende | 1000 / Anfang | 1000 / Mitte | 1000 / Ende | 3000 / Anfang | 3000 / Mitte | 3000 / Ende | 6000 / Anfang | 6000 / Mitte | 6000 / Ende |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Nomic Embed Text v1 | 1,000 | 0,967 | 0,942 | — | — | — | — | — | — | — | — | — |
| mxbai Embed Large | — | — | — | — | — | — | — | — | — | — | — | — |
| Qwen3 Embedding 8B | 0,924 | 0,877 | 0,895 | 0,912 | 0,899 | 0,885 | 0,975 | 0,934 | 0,954 | 1,000 | 0,965 | 0,961 |
| Qwen3 Embedding 0,6B | 0,656 | 1,000 | 1,000 | 0,988 | 0,938 | 1,000 | 0,975 | 0,951 | 1,000 | 1,000 | 0,926 | 1,000 |
| Qwen3 Embedding 4B | 1,000 | 1,000 | 1,000 | 1,000 | 1,000 | 1,000 | 1,000 | 1,000 | 1,000 | 1,000 | 1,000 | 1,000 |
| BGE-M3 | 0,951 | 0,988 | 0,877 | 0,951 | 0,914 | 0,877 | — | — | — | — | — | — |
| Jina Embeddings v2 DE | 1,000 | 0,951 | 0,766 | 1,000 | 1,000 | 0,963 | — | — | — | — | — | — |
| Multilingual E5 Large Instruct | — | — | — | — | — | — | — | — | — | — | — | — |
| Nomic Embed Text v2 MoE | — | — | — | — | — | — | — | — | — | — | — | — |
| Snowflake Arctic Embed 2 | 1,000 | 0,951 | 0,963 | 0,988 | 0,963 | 1,000 | — | — | — | — | — | — |
| EmbeddingGemma 300M | 0,643 | 0,877 | 0,815 | 0,729 | 0,926 | 0,963 | — | — | — | — | — | — |
Jeder Positionsblock enthält 60 Kandidatendokumente und 30 Fragen. Eine gültige Fassung ist relevant, der verworfene Entwurf nicht. Wiederholter Fülltext und feste Signalwörter begrenzen die Schwierigkeit dieses kontrollierten Versuchs. Ganze Dokumente und Abschnittskorpus sind unterschiedliche Aufgaben; ihre Scores dürfen nicht als direkte Wirksamkeitsmessung derselben Chunking-Entscheidung gegeneinander gerechnet werden.
Primärquellen
EmbeddingGemma: Modellkarte, Präfixe und Gemma-Nutzungsbedingungen
Qwen3 Embedding: Modellkarte und Apache‑2.0‑Lizenz
Jina v2 DE: Modellkarte und Apache‑2.0‑Lizenz
Jina AI: Zugehörigkeit zu Elastic
Nomic v2 MoE: Modellkarte, Präfixe und 512-Token-Kontext
Snowflake Arctic Embed 2: Modellkarte
BGE-M3: Modellkarte und MIT-Lizenz
E5 Large Instruct: Modellkarte und MIT-Lizenz
Mistral Embed: offizielle Modellbeschreibung und API-Angebot
Weitere getestete Karten: Nomic v1.5 · mxbai Embed Large · Qwen 0,6B · Qwen 8B. Maßgeblich bleiben die im Lauf protokollierten lokalen Digests.

Autor
Prof. Dr. Alexander Lutz, Professor für Big Data und KI an der FOM München, Doktor der Humangenetik und Anthropologie, ehemaliger Onlinespiele-Designer und natürlich Gründer und Inhaber der Agentur Die NEOs. Neben den Themen der künstlichen Intelligenz und deren Einsatzmöglichkeiten in der Praxis konzentriert sich Alexander auf die Kundenkommunikation. Neue Problemfelder oder technische Innovationen bereitet er so auf, dass der Nutzen für unsere Kunden deutlich wird. Er schläft zeitverantwortlich und agiert schnell, sein Motto: “Tue es, oder tue es nicht. Es gibt kein Versuchen.”
