Damit NOVA die richtige Textstelle findet, müssen Dokumente gut aufbereitet sein. Das Embedding-Modell ist ein Teil davon.
Diese Anleitung erklärt die Schritte vom Dokument zum Suchtreffer. Sie hilft Ihnen, die Einrichtung zu prüfen und Fehler einzugrenzen, wenn eine Antwort nicht zum hinterlegten Wissen passt.
Beim Vektorisieren übersetzt ein Embedding-Modell Texte in Zahlenfolgen. Diese Vektoren machen die inhaltliche Nähe von Texten vergleichbar. Verwandte Bedeutungen können so gefunden werden, auch wenn andere Wörter verwendet werden.
Ein Baumarktkatalog als Beispiel
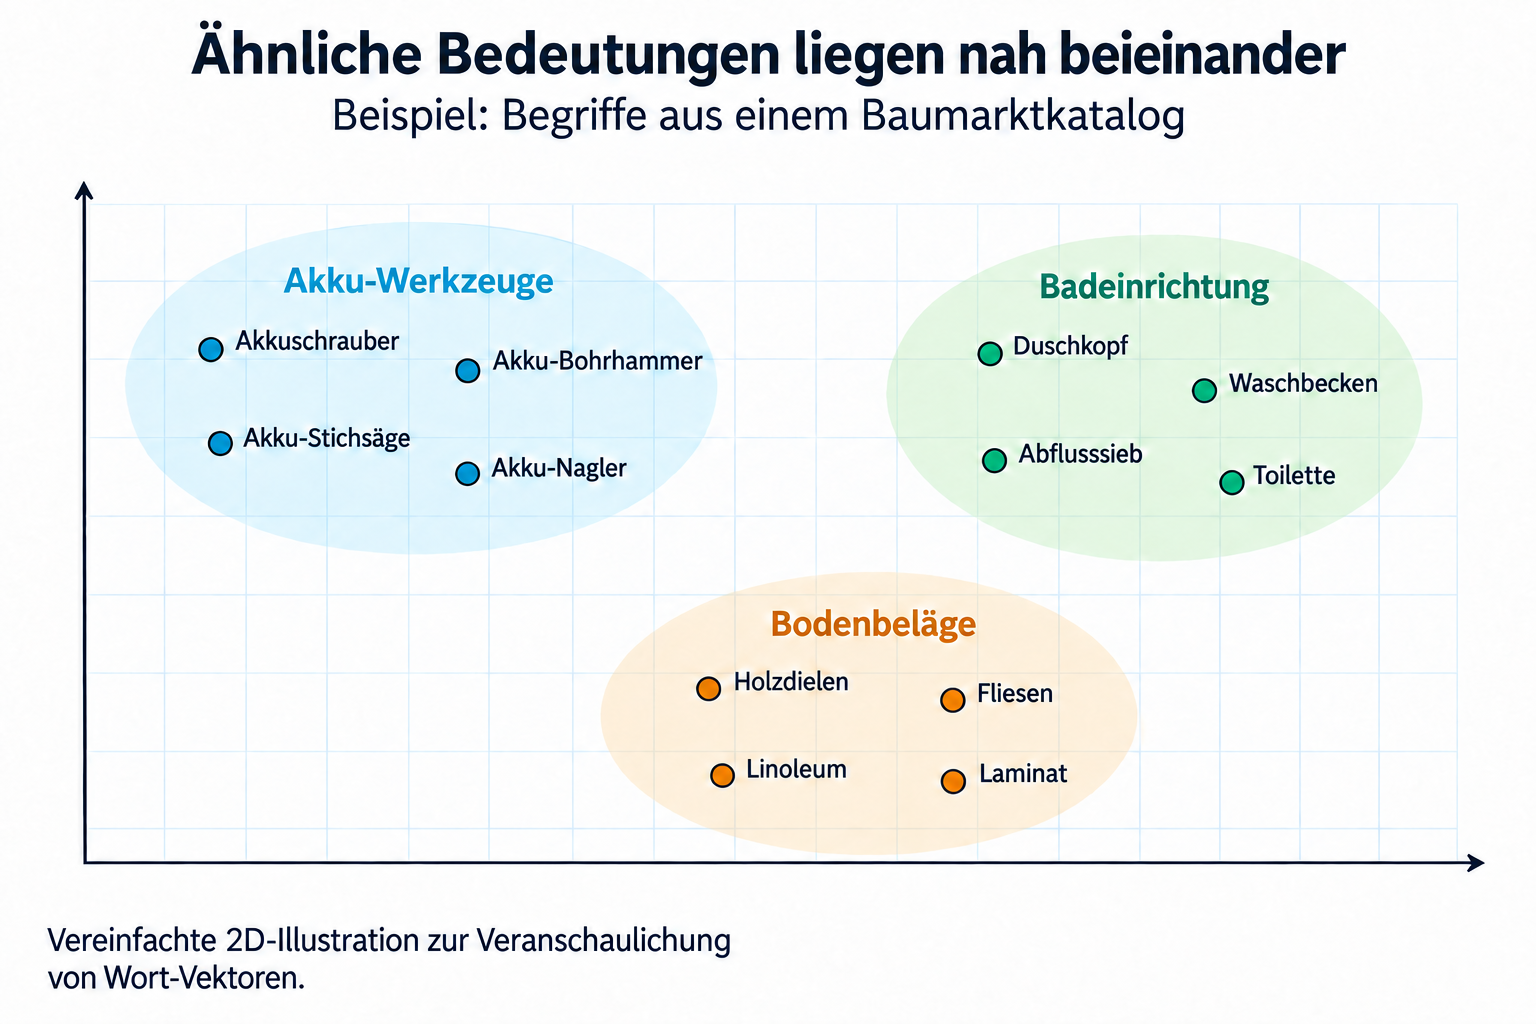
Akkuschrauber, Akku-Bohrhammer, Akku-Stichsäge und Akku-Nagler gehören zu den Akku-Werkzeugen. Duschkopf, Waschbecken, Abflusssieb und Toilette beschreiben die Badeinrichtung. Holzdielen, Fliesen, Linoleum und Laminat gehören zu den Bodenbelägen.
Stellen Sie sich diese Begriffe als Punkte auf einer Karte vor: Begriffe mit ähnlicher Bedeutung liegen näher beieinander. So werden Gruppen erkennbar, obwohl die Wörter unterschiedlich geschrieben sind.
Diese Karte ist eine Vereinfachung. Echte Embeddings haben viele Dimensionen; die Lage hängt vom Modell und vom Textzusammenhang ab. Fliesen können beispielsweise sowohl bei Bodenbelägen als auch bei einer Badsanierung eine Rolle spielen.
Verwandte Begriffe liegen im Bedeutungsraum nah beieinander
Verwandte Begriffe bilden Nachbarschaften im Bedeutungsraum. Die Grafik vereinfacht dieses Prinzip auf zwei Dimensionen.
Den richtigen Inhalt finden, ohne seinen Namen zu kennen
Sie möchten Urlaub einreichen, kennen aber den Namen des Formulars nicht. Statt nach »Urlaubsantrag« zu suchen, schreiben Sie:
»Wie kann ich eine Abwesenheit beantragen?«
Die semantische Suche kann darin den Bezug zu Urlaub und Freistellung erkennen. Ein Dokument mit dem Titel »Urlaubsantrag« kann deshalb als passender Treffer erscheinen, obwohl Ihre Frage dieses Wort gar nicht enthält. Entscheidend ist der Inhalt des Dokuments, nicht nur sein Dateiname.
Sie müssen also nicht immer den exakten Dokumentnamen oder dieselbe Formulierung verwenden. NOVA sucht auch nach inhaltlich passenden Textstellen. »Abwesenheit« kann allerdings ebenso eine Dienstreise oder eine andere Freistellung meinen. Je konkreter Ihre Frage ist, desto besser lässt sich die Suche eingrenzen.
Vom Dokument zur Antwort
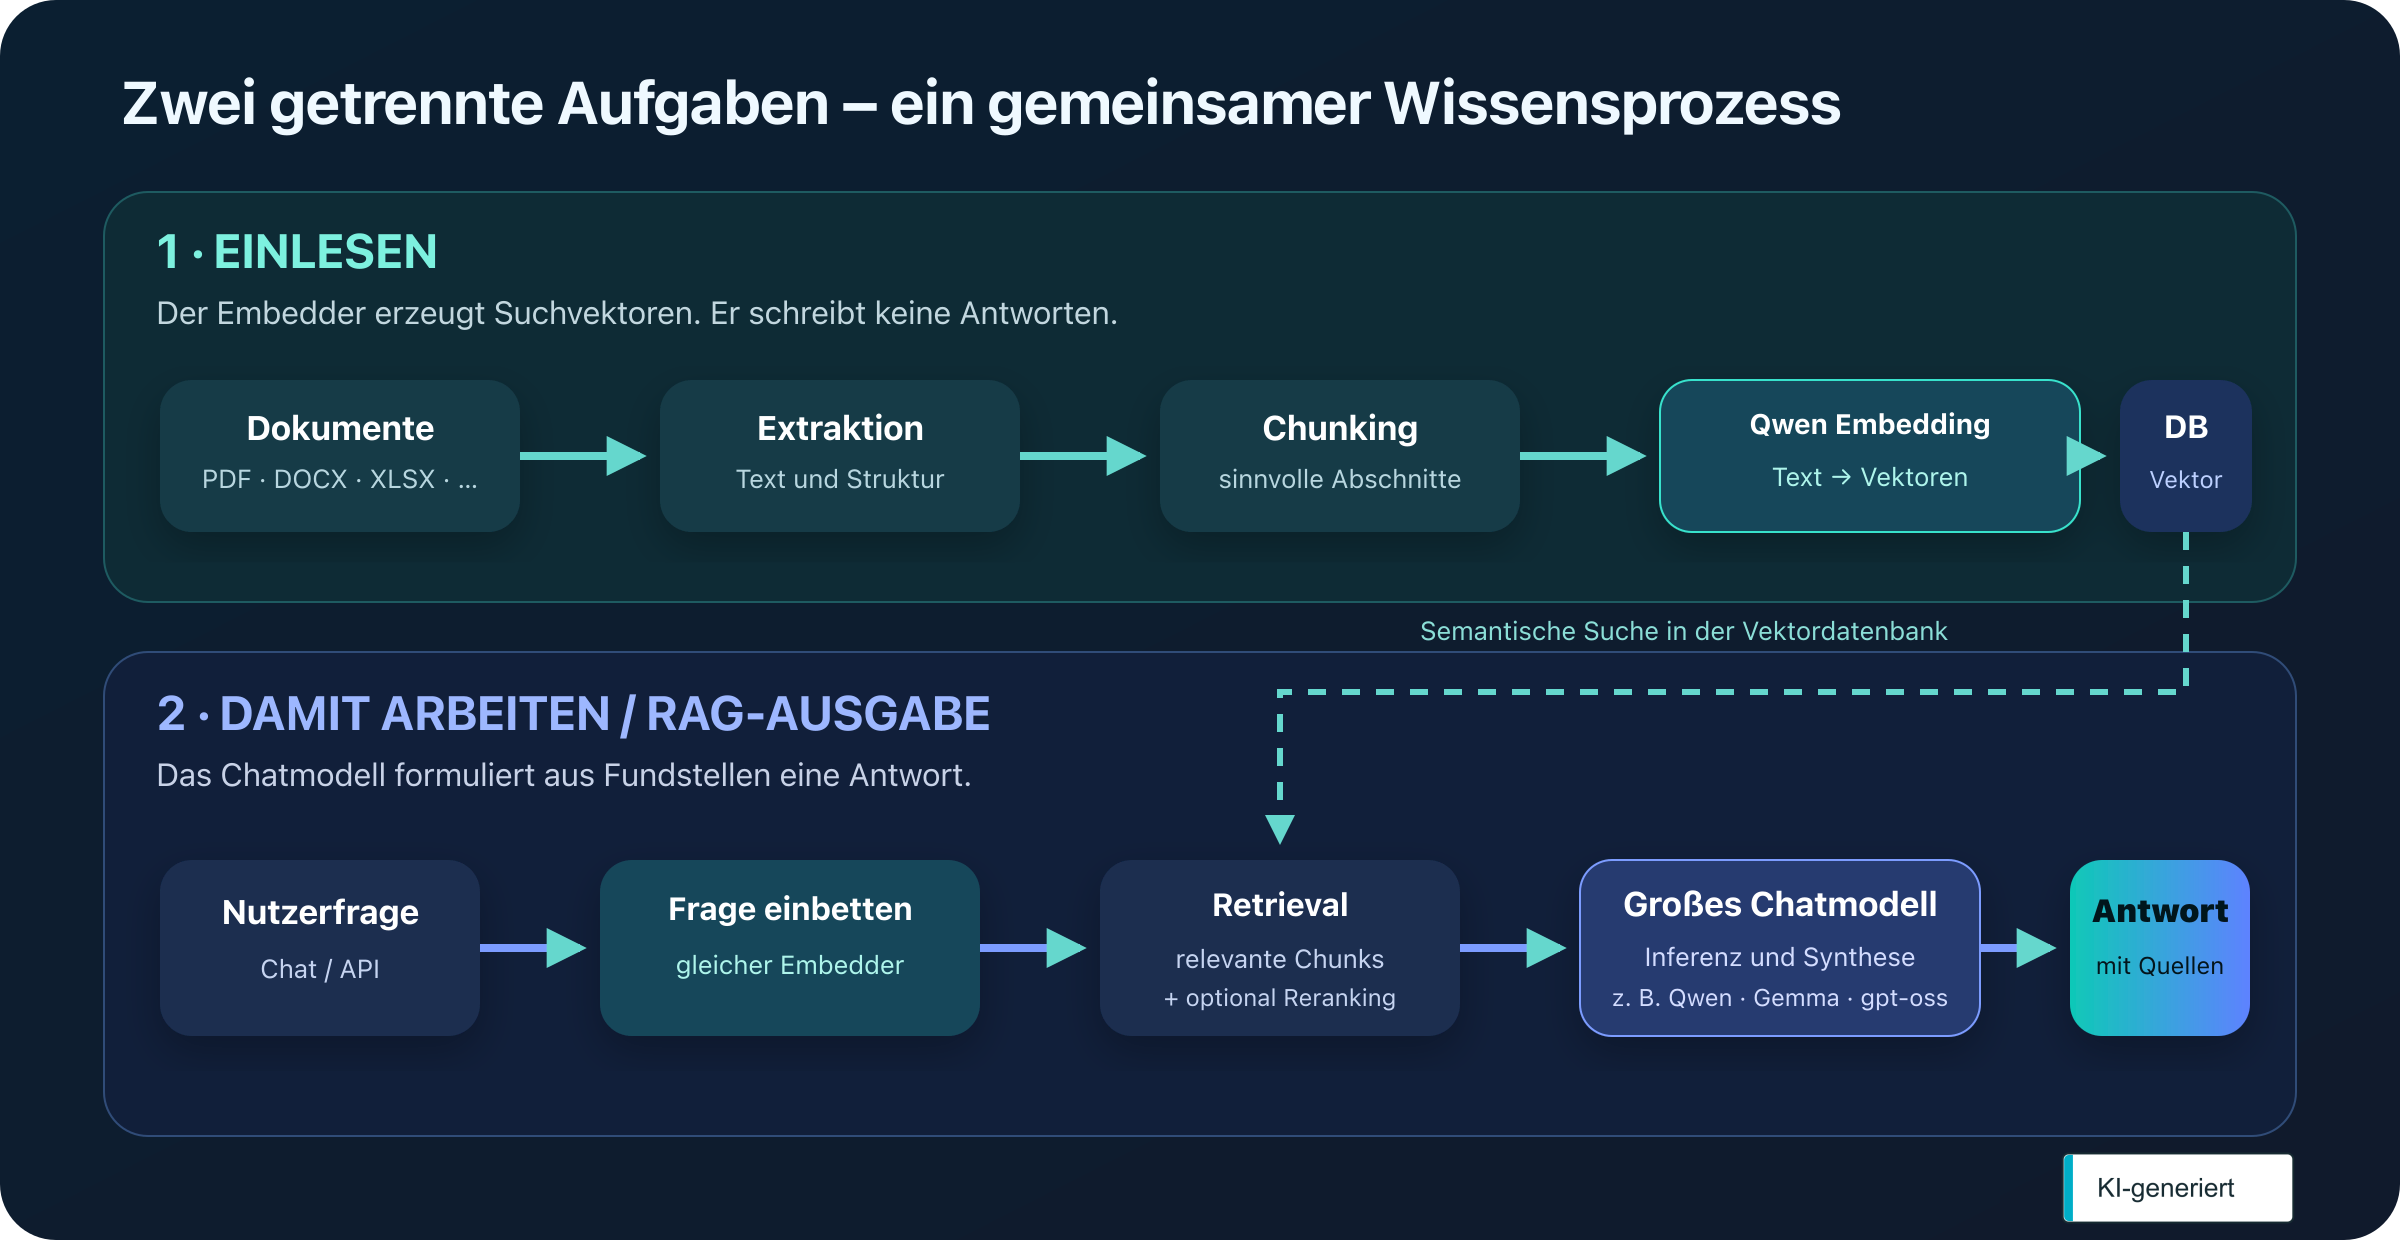
Beim Einlesen gewinnt NOVA Text aus der Datei und teilt ihn in Abschnitte. Das Embedding-Modell berechnet dafür Vektoren. Der Suchindex hält sie zusammen mit den Texten und Metadaten bereit.
Wenn Sie eine Frage stellen, wird auch diese für denselben Suchraum aufbereitet. Die Suche ermittelt passende Abschnitte aus dem freigegebenen Wissen. Erst danach formuliert das Chatmodell daraus eine Antwort. Diese Verbindung aus Suche und Antwortgenerierung heißt RAG.
Eine ähnliche Bedeutung ist noch kein Beweis für einen richtigen Treffer. Die genannte Quelle zeigt Ihnen, ob tatsächlich der passende Antrag oder die gesuchte Regel gefunden wurde.
Embedding und RAG im Überblick
Beim Einlesen entstehen Suchvektoren. Bei einer Frage werden passende Textstellen gesucht und an das Chatmodell übergeben. Qwen Embedding ist hier als Beispiel dargestellt.
Prüfen Sie zuerst die Textgewinnung. Bei einem gescannten PDF muss die Texterkennung brauchbare Inhalte liefern. Wiederholte Kopfzeilen, vertauschte Spalten oder Tabellen ohne verständlichen Zusammenhang können die Suche erschweren.
Verwenden Sie möglichst eindeutige Dateinamen und halten Sie den Dokumentstand fest. Wenn alte und neue Fassungen gleichzeitig in einer Sammlung liegen, sollte klar sein, welche davon gilt.
Dokumente für die Suche erschließen
Abschnitte mit Zusammenhang bilden
Die Aufteilung in Abschnitte wird auch Chunking genannt. Ein Abschnitt sollte genügend Zusammenhang enthalten, um eine Frage beantworten zu können. Zu kleine Ausschnitte verlieren leicht die Überschrift oder eine wichtige Einschränkung. Sehr große Abschnitte enthalten dagegen oft viel, was zur Frage nichts beiträgt.
Eine Überlappung zwischen benachbarten Abschnitten kann helfen, Informationen an einer Abschnittsgrenze zu erhalten. Stimmen Sie Größe und Überlappung anhand Ihrer Unterlagen ab.
Das maximale Kontextfenster des Embedding-Modells ist eine Obergrenze. Es ist keine Empfehlung, jeden Abschnitt bis zu dieser Grenze zu füllen.
Zusammenhängende Abschnitte bewahren den Kontext
Die Illustration zeigt das Prinzip der Aufteilung: Eine Überschrift bleibt mit dem zugehörigen Absatz verbunden. So gehen beim Vorbereiten für die Suche wichtige Zusammenhänge nicht verloren.
Die Einrichtung abstimmen
Diese Einstellungen betreffen die Administration. Wer NOVA im Alltag nutzt, muss dafür kein Embedding-Modell im Chat auswählen.
Der Embedder gehört zur Wissensverarbeitung. In der normalen Chat-Auswahl sollte er nicht als Gesprächsmodell angeboten werden.
Endpunkt und Modell
Prüfen Sie, welchen Embedding-Endpunkt Ihre Installation verwendet und welche Modellkennung dieser erwartet. Die Kennung muss zum bereitgestellten Modell passen. Ein lokal verfügbares Modell und ein externer Endpunkt können unterschiedlich bezeichnet sein.
Stapelgröße
Die Batchgröße bestimmt, wie viele Eingaben gemeinsam verarbeitet werden. Größere Stapel können den Durchsatz verbessern, benötigen aber mehr Ressourcen. Beginnen Sie mit einem kleinen Testbestand und passen Sie die Größe an Speicher, Dokumentlängen und die Grenzen des Endpunkts an.
Warten Sie nach dem Upload auf den Abschluss der Verarbeitung. Eine bereits vergebene Datei-ID bedeutet noch nicht, dass das Dokument durchsuchbar ist.
Vergleichen Sie Modelle mit Fragen aus Ihrem eigenen Dokumentbestand. Entscheidend ist, ob die gesuchten Passagen unter den Treffern auftauchen und wie lange Einlesen und Suche dauern. Ein allgemeiner Benchmark ersetzt diesen Test nicht.
Achten Sie auf die Sprachen Ihrer Unterlagen und auf Fachbegriffe. Beziehen Sie auch den benötigten Speicher und den vorgesehenen Betriebsort in die Auswahl ein.
Embedding-Modelle im Vergleich
Unsere Excel-Übersicht stellt 15 Modellvarianten aus dem Dokumentationspaket gegenüber. Sie finden darin Größenangaben, Hinweise zu Sprachen und Eingabelängen sowie Besonderheiten für den Einsatz. Die verlinkten Quellen zeigen, auf welche konkrete Variante sich die Angaben beziehen.
Die Übersicht hilft Ihnen, Kandidaten für einen Test mit Ihren eigenen Dokumenten auszuwählen. Sie enthält keine pauschale Rangliste. Stand: 5. Oktober 2026.
Für Ihren Einsatz zählt, wie gut ein Embedding-Modell die Fragen und Fachbegriffe Ihres Dokumentbestands abbildet. Prüfen Sie bei der Einrichtung auch die unterstützte Eingabelänge und die Vektordimension des tatsächlich eingesetzten Modells.
Ein größeres Modell ist keine automatische Zusage für bessere Treffer in Ihrem Bestand. Vergleichen Sie zunächst die Ergebnisse bei gleicher Dokumentaufbereitung. Ändern Sie anschließend einzelne Einstellungen gezielt, damit die Wirkung erkennbar bleibt.
Die Suche nachvollziehbar prüfen
Wählen Sie Fragen, deren Antwort und Fundstelle Sie bereits kennen. Ergänzen Sie eine Frage, die sich aus den Unterlagen nicht beantworten lässt.
Halten Sie bei jedem Durchlauf den Dokumentstand, das Modell und die Einstellungen fest.
Legen Sie für jede Testfrage fest, welche Passage als Treffer erwartet wird.
Stellen Sie die Frage mit der vorgesehenen Wissenssammlung und einem Konto aus der späteren Benutzergruppe.
Öffnen Sie die gefundenen Quellen. Prüfen Sie, ob die erwartete Passage enthalten und verständlich abgegrenzt ist.
Vergleichen Sie die formulierte Antwort mit der Quelle. Fehlt bereits der richtige Treffer, untersuchen Sie die Suche. Ist der Treffer richtig, die Antwort aber falsch, prüfen Sie den bereitgestellten Kontext und das Chatmodell.
Wiederholen Sie den Test nach einer Änderung mit denselben Fragen. Notieren Sie auch neu entstandene Fehler.
Wenn Treffer fehlen
Kontrollieren Sie, ob die Datei vollständig verarbeitet wurde, ob die richtige Sammlung ausgewählt ist und ob das Testkonto darauf zugreifen darf. Prüfen Sie danach den gewonnenen Text und seine Aufteilung.
Enthält der Text die gesuchte Information, testen Sie die Frage mit anderen Formulierungen. Wiederholt unpassende Treffer sind ein Anlass, Modell und Suchkonfiguration gemeinsam zu untersuchen.
Was bei einem Modellwechsel passiert
Ein Wechsel des Chatmodells erfordert normalerweise keine neuen Embeddings. Die Suche kann denselben Wissensbestand weiterverwenden.
Beim Wechsel des Embedding-Modells müssen Dokumente und Suchanfragen wieder im selben Vektorraum liegen. Planen Sie dafür eine erneute Indexierung. Auch eine geänderte Abschnittsaufteilung muss im Index neu aufgebaut werden.
Erproben Sie die Umstellung an einer separaten Testsammlung. Vergleichen Sie die Treffer mit dem bisherigen Stand, bevor Sie den produktiven Bestand umstellen.
Beschreiben Sie uns, welche Unterlagen Sie erschließen möchten und wer damit arbeiten soll. Wir besprechen mit Ihnen die passende Einrichtung.