Entwicklung · Administration · Integration
Technik verstehen.
Nova sicher betreiben.
Die Referenz für Architektur, Dokumentverarbeitung, Modellanbindung und Betrieb – für lokale Installationen und NEOs Private Cloud.
Orientierung und technische Gültigkeit
Dieses Handbuch beschreibt NEOs Quantum Nova für Entwicklung, Administration und Integration. Es ergänzt die Anwenderdokumentation. Die Bedienung der Oberfläche steht dort; hier stehen Komponenten, Datenwege, Schnittstellen und Betriebsverfahren.
Die Referenzversion des Produkts ist 26.0.12.0. Dieses Handbuch ist Version 1.3.0-Rev4 vom 2026-10-16. Es ist ein vollständiger erster Referenzentwurf zur Prüfung. Der beschriebene Funktionsumfang ist noch nicht durch einen durchgängigen Abnahmetest dieser Produktversion bestätigt.
Wie Angaben zu lesen sind
»Belegte Konfiguration« bezeichnet Werte aus den bereitgestellten Administrationsansichten und der neutralisierten Containerkonfiguration. Das belegt Einstellungen, jedoch keinen erfolgreichen Verarbeitungslauf. »Integrationsvorlage« bezeichnet ausführbaren Beispielcode, dessen konkrete Endpunkte und Antwortformate vor dem produktiven Einsatz an der Zielinstanz zu prüfen sind. »Betriebsempfehlung« beschreibt ein Verfahren, keine bereits eingerichtete Funktion.
Die dokumentierte Ist-Konfiguration stammt aus einer gehosteten Installation. Lokale Installationen nutzen denselben logischen Aufbau; Hardware, Speicher, Netzwerk, Rechte und aktivierte Funktionen können abweichen. Es werden keine Leistungswerte, SLA, gesetzlichen Konformitätszusagen oder automatischen Fallbacks zugesichert.
| Bereich | Stand dieses Entwurfs |
|---|---|
| Architektur und Betriebsprofile | Aufbau und Zuständigkeiten beschrieben; lokale und gehostete Variante getrennt. |
| Ingest und RAG | Einstellungen belegt; Extraktionsqualität, aktive Indexabfragen und Reindex-Abdeckung noch praktisch zu prüfen. |
| REST-API | Routen und Vorlagen dokumentiert; keine schreibenden Tests auf einer Kundeninstanz durchgeführt. |
| Betrieb und Sicherheit | Verfahren beschrieben; konkrete Aufbewahrungsfristen, Sicherungsziele und Identitätsanbieter werden je Installation festgelegt. |
Systemarchitektur und Komponenten
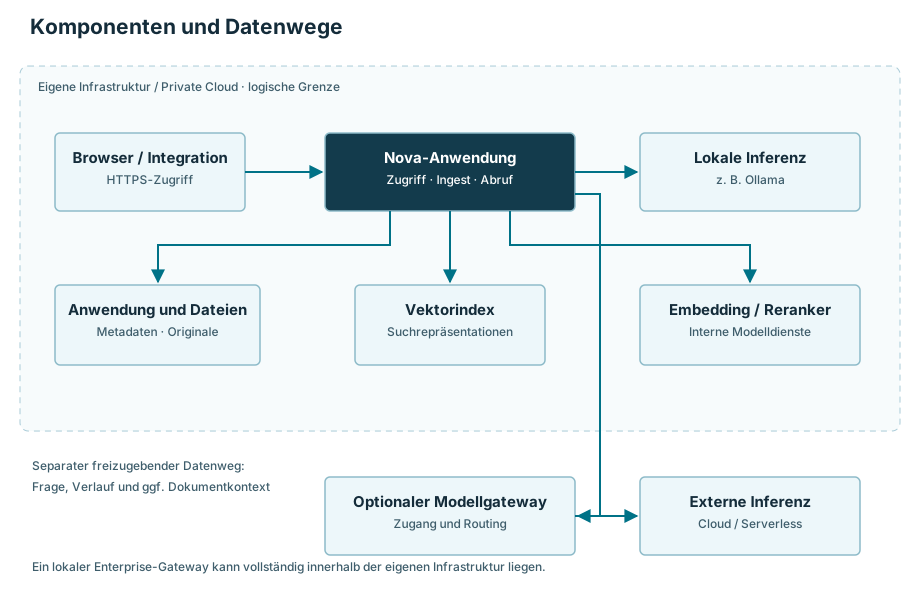
Nova verbindet Benutzerzugriff, Dokumentenverarbeitung, Wissensabruf und Modellaufrufe. Die Anwendung hält Benutzer- und Ressourceninformationen sowie Dateibezüge vor. Der Vektorspeicher enthält Suchrepräsentationen und Metadaten. Ein Embedding-Dienst berechnet Vektoren; ein generatives Modell erstellt Antworten. Diese Aufgaben können verschiedene Dienste und Hardware nutzen.

Im belegten Containeraufbau laufen Nova und ein Ollama-Dienst gemeinsam. Das Nova-Datenverzeichnis ist persistent eingebunden; die Modelldateien des Ollama-Dienstes besitzen ein eigenes Volume. Ein separater Modellgateway-Stack besteht aus LiteLLM und PostgreSQL. Dessen Datenbank ist dem Gateway zugeordnet. Daraus folgt nicht, dass Nova seine Dokumentvektoren in PostgreSQL speichert.
Speicher und Verantwortung
Anwendungsdaten, Originaldateien, Suchindex und Modelle haben unterschiedliche Lebenszyklen. Ein neu aufgebauter Index ersetzt keine Sicherung der Originaldateien und ihrer Rechte. Ein gespeicherter Chat ersetzt keine versionierte Wissensquelle. Der Gateway kann Zugang und Modellrouting bündeln; er entscheidet nicht automatisch über die Zugriffsrechte einer Wissenssammlung in Nova.
| Komponente | Aufgabe | Betriebsgrenze |
|---|---|---|
| Nova-Anwendung | Benutzer, Chats, Ressourcen, Ingest-Steuerung und Modellaufrufe | Mit persistentem Datenbereich betreiben. |
| Embedding und Reranking | Vektorisierung beziehungsweise erneute Bewertung von Suchtreffern | Lokalen Dienst und Modellverfügbarkeit prüfen. |
| Vektorspeicher | Vektoren und Suchmetadaten | Chroma-Datei belegt; aktives Backend noch nicht durch Abfrage bestätigt. |
| Ollama | Lokale Modellbereitstellung | Nur aus vorgesehenem Netz erreichbar machen. |
| Optionaler LiteLLM-Gateway | Anbindung und Verwaltung von Modellzugängen | Eigene Konfiguration und eigene Datenbank sichern. |
| Externer Inferenzdienst | Generative Modellberechnung | Übertragene Inhalte und Anbieterbedingungen separat bewerten. |
Einrichtung und Betriebsprofile
Vor der Einrichtung wird ein Betriebsprofil festgelegt. Der Standort der Nova-Anwendung und der Standort der Inferenz sind getrennte Entscheidungen. Eine lokal installierte Nova kann Cloud-Modelle aufrufen; eine Private-Cloud-Installation kann einen internen Embedding-Dienst verwenden.
| Aspekt | Lokal | NEOs Private Cloud | Enterprise mit lokalem Gateway |
|---|---|---|---|
| Anwendung und Daten | Infrastruktur des Kunden | Von NEOs betriebene private Umgebung | Infrastruktur des Kunden |
| Embedding | Intern erreichbarer Modellservice | Im belegten Profil interner Ollama-Dienst | Interner Dienst; keine zentrale Verbindung erforderlich |
| Generative Inferenz | Lokal oder ausdrücklich freigegebener Cloud-Zugang | Je Modell konfigurierte Anbindung | Lokaler LiteLLM-Layer, z. B. zu Ollama auf einem Mac |
| Externe Verbindung | Nur nach Freigabe | Abhängig vom gewählten Modell | Keine Voraussetzung einer Verbindung zum zentralen NEOs-Gateway |
| Betrieb | Zuständigkeit vertraglich festlegen | Zuständigkeit mit NEOs abstimmen | Netze, Identitäten und Freigaben mit Kundenbetrieb abstimmen |
Reihenfolge der Inbetriebnahme
- Version, Betriebsprofil, Verantwortliche und freigegebene Datenklassen festhalten.
- Persistenten Anwendungsspeicher, Modellverzeichnis, HTTPS-Zugang und internes Dienstnetz bereitstellen.
- Authentifizierung und Administratorzugriff einrichten, anschließend einen normalen Testbenutzer anlegen.
- Modellverbindungen und Embedding-Konfiguration prüfen. Eine kleine, nicht vertrauliche Datei einlesen.
- Mit einer bekannten Frage Abruf, Quellen und fehlende Berechtigungen prüfen.
- Sicherung und Wiederherstellung in einer getrennten Umgebung erproben, bevor produktive Daten aufgenommen werden.
Eine allgemeingültige Compose-Datei wird hier bewusst nicht als produktionsfertige Installation ausgeliefert: Imagezugang, Secrets, Domäne, Ressourcen und Speichereinbindung sind installationsabhängig. Container dürfen nicht allein aufgrund eines »läuft«-Status als fachlich betriebsbereit gelten.
Oberfläche und Arbeitsbereiche
Chat, Projektordner und Wissenssammlungen unterstützen unterschiedliche Arbeitsweisen. Die Anwenderdokumentation erläutert den Einstieg in die Oberfläche. Für eine technische Inbetriebnahme sind zusätzlich der Modellkatalog, ein erfolgreicher Dokumentlauf und ein Zugriffstest mit eingeschränktem Benutzer erforderlich.
Dokumenten-Ingest
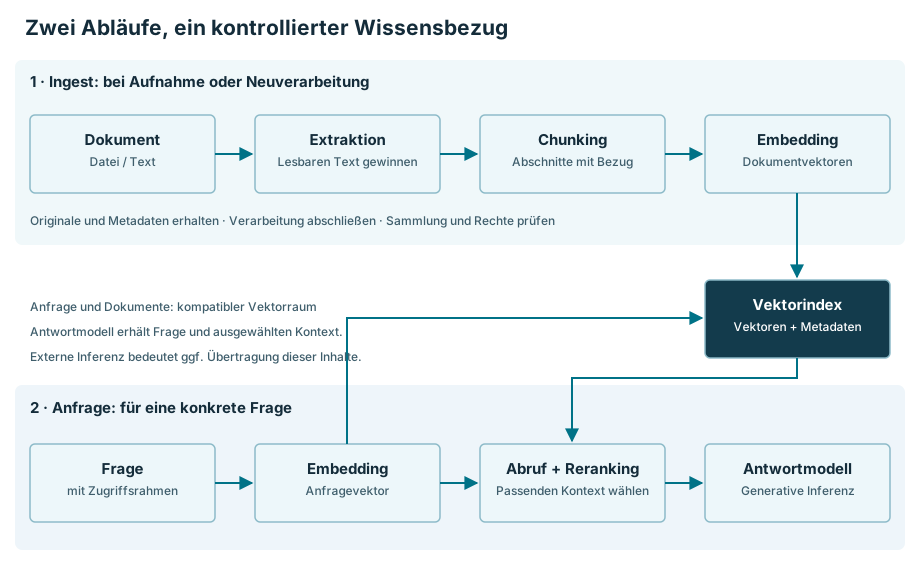
Ingest umfasst Upload, Textextraktion, Segmentierung, Embedding und Speicherung im Suchindex. Erst wenn die Verarbeitung abgeschlossen und das Dokument der vorgesehenen Ressource zugeordnet ist, darf ein Integrationsprozess die Datei als für den Abruf vorbereitet behandeln. Anschließend prüft eine Testfrage, ob der Inhalt tatsächlich auffindbar ist.
Manueller Ablauf
- Datei und Berechtigung prüfen. Für einen Ersttest eine kurze Datei mit eindeutigem Inhalt verwenden.
- Datei in die vorgesehene Wissenssammlung aufnehmen und den Verarbeitungsstatus abwarten.
- Extrahierten Inhalt beziehungsweise Quellenansicht auf Seitenbezug, Tabellen und Sonderzeichen prüfen.
- Eine Frage stellen, deren Antwort eindeutig im Dokument steht, und eine Kontrollfrage stellen, deren Antwort fehlt.
- Mit einem Benutzer ohne Sammlungszugriff prüfen, dass keine geschützten Inhalte abgerufen werden.
Belegte Verarbeitungseinstellungen
Die folgenden Werte wurden am 2026-10-16 im angemeldeten System erneut abgelesen. Die Aufnahmen belegen die Konfiguration der betrachteten Installation. Sie sind keine pauschale Empfehlung für alle Dokumenttypen und kein Nachweis der Verarbeitungsgeschwindigkeit.
| Einstellung | Belegter Wert | Bedeutung |
|---|---|---|
| Inhaltsextraktion | Standard | Konkrete Parserbibliothek nicht aus der Ansicht ableitbar. |
| PDF-Loader | Seite | Seiten werden einzeln behandelt; Seitenbezüge und Tabellenübergänge prüfen. |
| Bilder aus PDFs extrahieren / OCR | Aus | Bildbasierte PDFs brauchen eine gesonderte Extraktionsprüfung. |
| Embedding und Retrieval umgehen | Aus | Der konfigurierte Weg nutzt segmentierten Abruf. |
| Text-Splitter | Token (Tiktoken) | Chunk-Größe 700 und Überlappung 100 beziehen sich hier auf Token. |
| Markdown-Header-Splitter | Ein | Überschriften strukturieren die nachfolgende Aufteilung. |
| Minimaler Chunk-Zielwert | 350 | Zusammenführen kleiner Abschnitte nach Möglichkeit; genaue Einheit noch nicht verifiziert. |
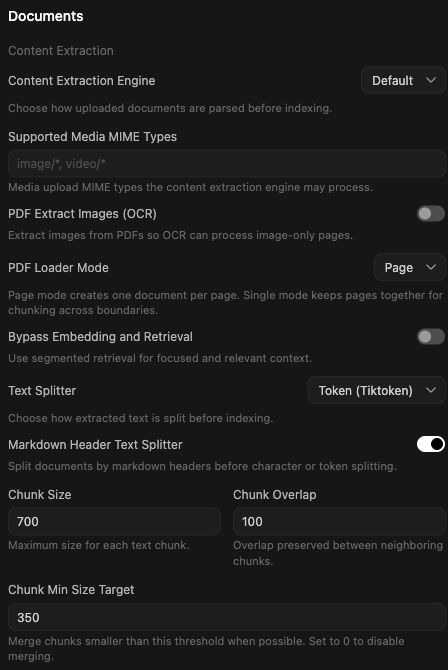
Ein Token ist nicht gleich einem Zeichen oder Wort. Der ausgewählte Splitter kann anders tokenisieren als das Embedding- oder Antwortmodell. Überlappung erhält Übergänge, vergrößert aber Index und Verarbeitung. Eine Tabellenzeile oder Überschrift darf beim Aufteilen nicht ohne ihren notwendigen Bezug stehen bleiben.
Dateiformate und Grenzen
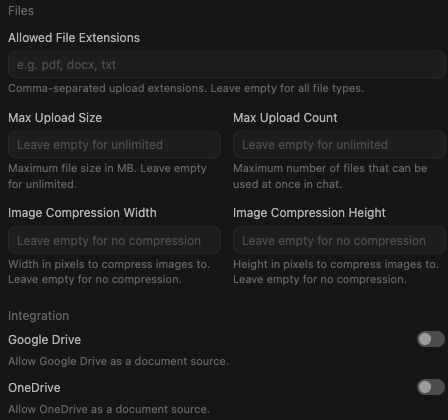
In den bereitgestellten Ansichten sind keine festen Werte für erlaubte Endungen, maximale Uploadgröße oder Uploadanzahl eingetragen. Das bedeutet keine bestätigte unbegrenzte Verarbeitung. Reverse Proxy, Server, Parser und Modell können Grenzen setzen. Für PDFs, Office-Dateien, Text und Tabellen wird ein installationsbezogener Testsatz benötigt; eine Dateiendung allein belegt die korrekte Textextraktion nicht. Google Drive und OneDrive sind in der belegten Konfiguration deaktiviert.
Ingest über die API
Die Integrationsvorlage in Kapitel 11 wartet nach dem Upload auf completed und ordnet erst danach zu. Ein HTTP-Erfolg des Uploads ist noch kein fertiger Suchindex. Bei einem Timeout wird die ausgegebene Datei-ID untersucht, bevor ein erneuter Upload erfolgt; sonst können Duplikate entstehen.
Embedding und Vektordatenbank
Ein Embedding-Modell wandelt Text in numerische Vektoren um. Dokumentabschnitte und Suchanfragen müssen im selben kompatiblen Vektorraum liegen. Ähnliche Vektoren helfen beim Finden passender Textstellen; sie beweisen weder Wahrheit noch ausreichenden Kontext. Auch die Erzeugung eines Embeddings ist Inferenz, jedoch keine generative Antworterstellung.
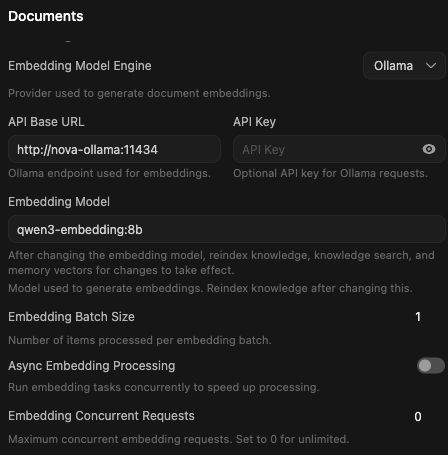
| Einstellung | Belegte Konfiguration |
|---|---|
| Engine und Modell | Ollama · qwen3-embedding:8b |
| Embedding-Endpunkt | http://nova-ollama:11434 im internen Dienstnetz |
| Batch-Größe | 1 |
| Asynchrone Embedding-Verarbeitung | Aus |
| Gleichzeitige Anfragen | 0; laut Oberfläche keine konfigurierte Begrenzung, keine Aussage über verfügbare Rechenkapazität. |
| Warmhalten | OLLAMA_KEEP_ALIVE=-1 im bereitgestellten Dienst konfiguriert; aktueller Ladezustand nicht gemessen. |
Welcher Speicher ist belegt?
Im persistenten Nova-Datenbereich wurde die Datei vector_db/chroma.sqlite3 gefunden. Das belegt einen vorhandenen Chroma-Speicherbestand. Der aktive Backendpfad wurde noch nicht durch eine Laufzeitabfrage bestätigt. Eine nicht ausdrücklich gesetzte Backendvariable ist kein Beweis für den aktuell wirksamen Standard. Die PostgreSQL-Datenbank des getrennten Modellgateways wird daher nicht als Nova-Vektordatenbank dargestellt.
Modellwechsel und Neuindizierung
Ein anderes Embedding-Modell kann andere Dimensionen, Normalisierung und Ähnlichkeitswerte erzeugen. Bestehende Dokumentvektoren dürfen nicht ohne Prüfung mit neuen Anfragevektoren kombiniert werden. Vor einem Wechsel werden Bestand, Modell-ID, Dimension und Indexkonfiguration gesichert. Danach wird ein neuer konsistenter Index aufgebaut und mit Kontrollfragen verglichen. Ein bloßer Eintrag des neuen Modellnamens stellt den Bestand nicht automatisch um.
Wenn die Extraktion oder Chunk-Aufteilung geändert wird, kann zusätzlich eine erneute Verarbeitung der Originaldateien nötig sein. Re-Embedding vorhandener Abschnitte ist etwas anderes als erneutes Extrahieren und Segmentieren. Die genaue Abdeckung der angebotenen Neuindizierungsaktion ist vor einem großen Umbau in einer Testumgebung zu prüfen.
Embedding-Vergleich als Excel herunterladen
Die Tabelle ist eine sachliche Auswahlhilfe mit Stand 5. Oktober 2026. Sie ist keine Rangliste und kein Leistungsnachweis für die eigene Installation. Die Entscheidung fällt anhand von Sprache, Dokumenttyp, Hardware, Lizenz, Datenschutz und einem eigenen Suchtestsatz.
Retrieval-Augmented Generation
Bei RAG sucht Nova zuerst zu einer Frage passende Dokumentabschnitte und stellt diese dem Antwortmodell als Kontext zur Verfügung. Die Quelle bleibt im Wissensbestand; das Modell wird dadurch nicht neu trainiert. Ein Modell kann trotz passendem Kontext unzutreffend zusammenfassen oder eine Quelle falsch zuordnen. Quellenprüfung gehört deshalb zum Arbeitsablauf.

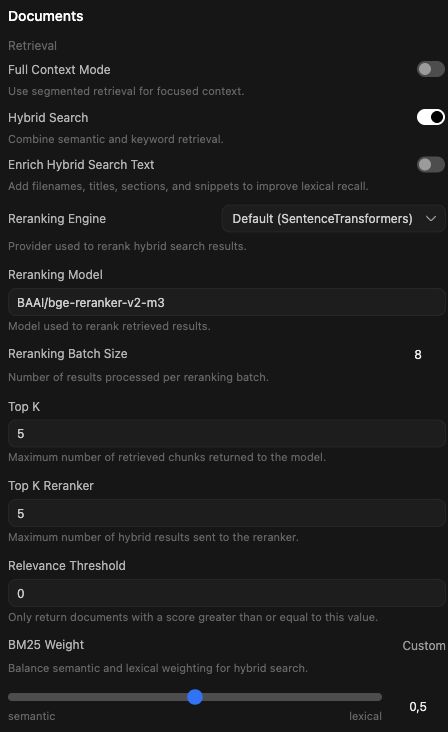
| Abrufparameter | Belegter Wert |
|---|---|
| Vollkontext-Modus | Aus |
| Hybride Suche | Ein |
| Hybrid-Suchtext anreichern | Aus |
| BM25-Gewichtung | 0,5; benutzerdefinierte Einstellung |
| Reranking | Standard (SentenceTransformers), BAAI/bge-reranker-v2-m3 |
| Reranking-Batch | 8 |
| Top K | 5; maximale zurückgegebene Chunk-Anzahl laut Oberfläche. |
| Top K Reranker | 5; maximale hybride Kandidatenzahl für den Reranker laut Oberfläche. |
| Relevanzschwelle | 0; keine zusätzliche positive Mindestschwelle konfiguriert. |
Semantische Suche, Stichwortsuche und Reranking
Die semantische Suche nutzt Vektornähe. Die lexikalische Suche berücksichtigt Wörter und Begriffe, etwa Produktnummern. Die hybride Suche kombiniert beide Wege. Eine Gewichtung von 0,5 beschreibt eine Einstellung der Kombination; sie garantiert keine gleich großen Trefferanteile oder optimale Qualität. Der Reranker bewertet zunächst gefundene Kandidaten erneut. Er kann keine Dokumente finden, die vorher nicht als Kandidaten abgerufen wurden.
Kontext und Quellen
Die belegte RAG-Vorlage verwendet {{CONTEXT}}. Sie fordert Inline-Quellenverweise nur für Quellelemente mit ausdrücklicher ID und eine Antwort in der Sprache der Frage. Sie erlaubt zugleich ergänzendes Modellwissen, wenn dessen Verwendung kenntlich gemacht wird. Die aktuelle Vorlage erzwingt damit keinen ausschließlich dokumentgebundenen Antwortmodus.
Eine Prompt-Regel ist keine Zugriffssperre. Geschützte Sammlungen müssen vor der Kontextzusammenstellung über Ressourcenrechte abgegrenzt sein. Dokumentinhalte können irreführende Handlungsanweisungen enthalten; solche Inhalte dürfen keine administrativen Rechte erhalten. Bei Cloud-Inferenz können die abgerufenen Abschnitte Teil der übertragenen Anfrage werden.
Qualität prüfen
Ein geeigneter Testsatz enthält eindeutige Faktenfragen, Zahlen mit Einheiten, Synonyme, Kennungen, fehlende Antworten und widersprüchliche Dokumentstände. Pro Frage werden erwartete Quelle und relevante Passage festgehalten. Nach einer Änderung werden Abruf und Antwort getrennt bewertet: War die richtige Passage unter den Treffern, und hat das Modell sie korrekt verwendet?
Sprachmodelle und Inferenzarchitekturen
Ein generatives Sprachmodell verarbeitet Eingaben und erzeugt Ausgaben. Modellfamilie, konkrete Modell-ID, Quantisierung, Laufzeit und Kontextgrenze sind unterschiedliche Angaben. Eine Familie kann in mehreren Varianten verfügbar sein. Die technische Anbindung benötigt immer die tatsächlich freigegebene ID aus dem Modellkatalog der jeweiligen Instanz.
Nova kann lokale und externe Modelle bereitstellen. Die Auswahl in der Oberfläche sagt allein nichts über den Standort der Berechnung aus. Ein verständlicher Anzeigename sollte daher durch eine intern gepflegte Zuordnung zu Endpunkt, Betreiber, Datenweg und Kostenregel ergänzt werden.
| Aufgabe | Modelltyp | Prüffrage |
|---|---|---|
| Dokumente und Fragen vektorisieren | Embedding-Modell | Sind Modell und Vektorraum kompatibel? |
| Gefundene Passagen ordnen | Reranker | Verbessert die Reihenfolge den geprüften Abruf? |
| Antwort formulieren | Generatives Sprachmodell | Reichen Kontext, Sprache und Antwortqualität für den Zweck? |
| Bilder auswerten | Modell mit Bildverarbeitung, sofern angebunden | Welche Formate und Inhalte erreichen den Dienst tatsächlich? |
Kontextbudget
Systemanweisungen, Gesprächsverlauf, Suchkontext, Werkzeuginhalte und gewünschte Antwort teilen sich das verfügbare Kontextbudget. Die maximale Kontextlänge eines Modells ist keine Empfehlung für die Chunk-Größe. Lange Kontexte können Kosten und Laufzeit erhöhen; ein vollständiges Dokument ist nicht automatisch besser als gezielt abgerufene Passagen.
Werkzeuge und strukturierte Ausgaben
Ob ein Modell Werkzeugaufrufe oder ein bestimmtes Ausgabeschema unterstützt, hängt von Modell, Dienst, Adapter und Nova-Konfiguration ab. Ein ausgegebener Werkzeugaufruf ist noch keine ausgeführte Aktion. Zuständigkeit für Ausführung, Validierung und Berechtigungen muss pro Integration festgelegt werden. Automatische Agentenabläufe und Fallbackketten sind in diesem Referenzstand nicht als eingerichtete Funktionen nachgewiesen.
Lokale Inferenz
Lokale Inferenz hält die Modellberechnung innerhalb der vorgesehenen eigenen Infrastruktur. Das kann ein Server oder beispielsweise ein Mac mit Ollama sein. Ob eine Installation vollständig ohne externe Verbindung arbeitet, hängt zusätzlich von allen Modellverbindungen, Downloads, Werkzeugen, Suche und Telemetrie ab. Der lokale Standort eines einzelnen Dienstes reicht als Nachweis nicht aus.
Interner Dienst und Host-Anbindung
Für das dokumentierte Embedding ist http://nova-ollama:11434 eingestellt. Der Name bezeichnet einen im Container-Netz erreichbaren Dienst. http://host.docker.internal:11434 ist eine separat genannte allgemeine Modellverbindung zum Host und nicht derselbe belegte Embedding-Endpunkt. Die Auflösung des Hostnamens und die Erreichbarkeit müssen zur verwendeten Containerumgebung passen.
# Beispiel: Zustand eines intern erreichbaren Ollama-Dienstes lesen.
# Adresse an das Netz anpassen, aus dem dieser Aufruf erfolgt.
curl --fail --show-error http://nova-ollama:11434/api/ps
Eine erfolgreiche Antwort zeigt aktuell geladene Modelle dieses Dienstes. Sie prüft noch nicht den vollständigen Nova-Ingest. Der Aufruf ist eine Diagnosevorlage und wurde für diesen Entwurf nicht am produktiven Dienst ausgeführt.
Ressourcen und Warmhalten
In der bereitgestellten Konfiguration sind OLLAMA_KEEP_ALIVE=-1, OLLAMA_MAX_LOADED_MODELS=1 und OLLAMA_NUM_PARALLEL=1 gesetzt. Das Warmhalten soll erneutes Laden vermeiden, reserviert aber Speicher. Ein einzelnes geladenes Modell und geringe Parallelität können Engpässe verursachen, wenn mehrere Aufgaben denselben Dienst nutzen. Daraus werden keine gemessenen Antwortzeiten abgeleitet.
OLLAMA_NO_CLOUD=true ist für diesen Ollama-Dienst konfiguriert. Andere Verbindungen der Nova-Anwendung werden dadurch nicht pauschal deaktiviert. Für ein isoliertes Enterprise-Profil werden ausgehende Verbindungen gezielt kontrolliert; der optionale lokale LiteLLM-Layer benötigt keinen Zugang zum zentralen NEOs-Gateway.
Cloud-Inferenz und Serverless GPU
Cloud-Inferenz verlagert Modellberechnung zu einem externen oder gesondert betriebenen Dienst. Serverless GPU bezeichnet eine Betriebsform, bei der Rechenkapazität bedarfsbezogen bereitgestellt wird. Serverless ist keine besondere RAG-Methode und sagt allein nichts über Datenschutz, Region oder Schnittstellenkompatibilität aus.
Der zentrale NEOs-Modellgateway https://llm.die-neos.de/v1 stellt nach der vorliegenden Betreiberangabe Cloud-Modelle bereit. Dieser Gateway ist nicht die Nova-REST-API. Die dokumentierte Embedding-Konfiguration ruft stattdessen den internen Ollama-Dienst auf.
| Variante | Datenweg | Betrieblich zu beachten |
|---|---|---|
| Lokaler Modelldienst | Nova → interner Dienst | Speicher, Modellinstallation, Last und internes Netz. |
| Cloud über Gateway | Nova → freigegebener Gateway → Modellanbieter | Zugänge, Modellzuordnung, Anbieter, Region und übertragene Inhalte. |
| Serverless mit kompatibler Chat-API | Nova oder Gateway → freigegebener Endpunkt | Kaltstart, Startverzögerung, Timeout, Kapazität und Kosten. |
| Serverless mit Job-API | Integration → Job anlegen → Status → Ergebnis | Separater Adapter nötig; kein direkter Ersatz einer Chat-API. |
Freigabe eines externen Modells
Vor der Freigabe werden Betreiber, Region, Aufbewahrung, Trainingsnutzung nach Vertrag, Zugangsschutz und Fehlerbehandlung geklärt. Übertragen werden können die Frage, Gesprächsverlauf, Systemanweisungen, abgerufene Dokumentpassagen und Werkzeugergebnisse. Die Originaldatei muss nicht vollständig übertragen werden, damit dennoch vertraulicher Inhalt den eigenen Bereich verlässt.
Für Serverless ist in diesem Referenzstand kein konkreter Anbieter oder Adapter als Standard festgelegt. Die Architektur bleibt dafür offen. Wiederholungen müssen zwischen einer sicher wiederholbaren Statusabfrage und einer möglicherweise doppelt berechneten oder doppelt abgerechneten Generierung unterscheiden. Rückfälle auf andere Anbieter erfolgen nur, wenn Datenweg und Verhalten ausdrücklich eingerichtet und freigegeben sind.
Wissenssammlungen und Modell-Presets
Eine Wissenssammlung bündelt Dokumente für den Abruf. Ein Modell-Preset bündelt Vorgaben für eine bestimmte Nutzung, etwa Systemanweisungen und zugeordnete Ressourcen. Ein Projektordner organisiert Arbeit; ein Kanal unterstützt Kommunikation. Diese Begriffe dürfen nicht mit einer getrennten Mandantenumgebung gleichgesetzt werden.
| Ressource | Zweck | Keine automatische Zusage |
|---|---|---|
| Wissenssammlung | Dokumentbestand mit Zugriff und Abrufbezug | Kein eigenes Modelltraining. |
| Modell-Preset | Wiederverwendbare Modellvorgaben und Ressourcenbezüge | Kein Ersatz für Ressourcenrechte. |
| Projektordner | Arbeitsorganisation und Zusammenfassung von Kontext | Keine bewiesene Mandantentrennung. |
| Kanal | Zusammenarbeit und Nachrichten | Keine automatische Freigabe aller Dokumente. |
Einrichtung einer Sammlung
- Verantwortliche Person, Zweck und erlaubte Datenklasse festlegen.
- Dokumentstand und Zugriffsgruppe definieren; widersprüchliche Altstände kennzeichnen oder aus dem aktiven Bestand nehmen.
- Dokumente einlesen und anhand eindeutiger Fragen prüfen.
- Das Preset mit der vorgesehenen Sammlung und einem geeigneten Modell verbinden.
- Mit berechtigtem und unberechtigtem Benutzer testen. Anzeigename und Auffindbarkeit reichen als Rechteprüfung nicht aus.
Export und Import
Preset-Exporte können die Wiederverwendung unterstützen. Sie sind keine vollständige Datensicherung: Dateien, Index, Benutzer, Rechte und andere Ressourcen können fehlen. Vor einem Import werden referenzierte IDs, Modellverfügbarkeit und mögliche ID-Konflikte in einer getrennten Testumgebung geprüft. Ein Import ist eine schreibende Änderung und darf nicht als folgenloses Aktualisieren angenommen werden.
REST-API
Die Nova-API wird am Origin der jeweiligen Nova-Instanz angesprochen, beispielsweise https://nova.example.org. In den Vorlagen enthält NOVA_URL weder /api noch /v1. Die Routen ergänzen diese Pfade selbst. Zugangsschlüssel gehören auf den Integrationsserver, niemals in öffentlich ausgeliefertes JavaScript, HTML, URL-Parameter oder ein Git-Repository.
| Methode und Route | Zweck |
|---|---|
GET /api/models | Sichtbaren Modellkatalog lesen. |
POST /api/chat/completions | Chat-Anfrage; Beispiele verwenden stream: false. |
POST /api/v1/files/ | Datei hochladen; Verarbeitung kann nach der Antwort fortlaufen. |
GET /api/v1/files/{file_id}/process/status | Verarbeitungsstatus einer Datei lesen. |
POST /api/v1/knowledge/{knowledge_id}/file/add | Fertige Datei einer Wissenssammlung zuordnen. |
GET /api/v1/models/export | Modell-Presets exportieren; Berechtigung prüfen. |
POST /api/v1/models/import | Modell-Presets importieren; Schema und Konfliktverhalten vorher prüfen. |
Vorlagen vorbereiten
Die Python-Vorlagen werden jeweils als ZIP-Datei angeboten. Das Archiv vor der Verwendung entpacken; darin liegen die unveränderte Python-Datei und eine kurze README. Auf dem Webserver muss dafür kein Python ausgeführt werden.
Die Python-Vorlagen benötigen Python 3 und das Paket requests. Die Umgebungsvariablen werden durch die verwendete Secret-Verwaltung oder eine geschützte Sitzung gesetzt. Für Chat ist eine reale Modell-ID aus dem Katalog erforderlich; ein Modell namens default wird nicht vorausgesetzt. Für den optionalen Wissensbezug beziehungsweise Ingest wird eine reale Sammlungs-ID benötigt.
| Variable | Inhalt |
|---|---|
NOVA_URL | HTTPS-Origin der Zielinstanz. |
NOVA_API_KEY | Geheim gehaltener Schlüssel eines passenden Integrationskontos. |
NOVA_MODEL_ID | Freigegebene Modell-ID. |
NOVA_COLLECTION_ID | Sammlungs-ID; für Ingest erforderlich, für Chat optional. |
Modellkatalog lesen
curl --fail --show-error -H "Authorization: Bearer $NOVA_API_KEY" "$NOVA_URL/api/models"Chat und Wissensbezug
Die folgende Vorlage erwartet eine JSON-Antwort mit choices[0].message.content. Eine Sammlung wird bei gesetzter ID ausdrücklich als files-Ressource übergeben. Ob ein Preset bereits einen Wissensbezug enthält, wird separat geprüft; es ersetzt nicht den Zugriffstest des Integrationskontos.
#!/usr/bin/env python3
"""NEOs Quantum Nova: nicht streamende Chat-Anfrage. Python 3, requests."""
import os
import requests

def main():
    origin = os.environ["NOVA_URL"].rstrip("/")
    token = os.environ["NOVA_API_KEY"]
    model = os.environ["NOVA_MODEL_ID"]
    payload = {
        "model": model,
        "messages": [{"role": "user", "content": "Fasse die Freigabeschritte zusammen."}],
        "stream": False,
    }
    collection = os.environ.get("NOVA_COLLECTION_ID")
    if collection:
        payload["files"] = [{"type": "collection", "id": collection}]
    response = requests.post(
        origin + "/api/chat/completions",
        headers={"Authorization": "Bearer " + token},
        json=payload, timeout=(10, 180),
    )
    response.raise_for_status()
    data = response.json()
    print(data["choices"][0]["message"]["content"])

if __name__ == "__main__":
    main()
Chat-Vorlage als ZIP herunterladen
Upload, Status und Zuordnung
Der Ablauf trennt drei Schritte. Nach einem Upload wird auf den Status completed gewartet. Fehlerzustände brechen ab. Erst anschließend wird die Datei zugeordnet. Es gibt keine automatischen Wiederholungen schreibender Aufrufe. Die Frist begrenzt das Polling; ein einzelner HTTP-Aufruf kann zusätzlich bis zu seinem Request-Timeout laufen.
#!/usr/bin/env python3
"""NEOs Quantum Nova: Upload, Verarbeitungsstatus, Zuordnung. Python 3, requests.
Schreibt in die gewählte Instanz. Zuerst mit Testdatei und Testsammlung prüfen.
Keine automatischen Wiederholungen von Upload oder Zuordnung.
"""
import os
import sys
import time
from pathlib import Path
import requests

def main():
    path = Path(sys.argv[1])
    origin = os.environ["NOVA_URL"].rstrip("/")
    collection = os.environ["NOVA_COLLECTION_ID"]
    session = requests.Session()
    session.headers["Authorization"] = "Bearer " + os.environ["NOVA_API_KEY"]
    with path.open("rb") as file:
        response = session.post(origin + "/api/v1/files/",
            files={"file": (path.name, file)}, timeout=(10, 180))
    response.raise_for_status()
    file_id = response.json()["id"]
    print("Datei-ID:", file_id, flush=True)
    deadline = time.monotonic() + 600
    while time.monotonic() < deadline:
        status_response = session.get(
            origin + f"/api/v1/files/{file_id}/process/status", timeout=(10, 30))
        status_response.raise_for_status()
        state = status_response.json().get("status")
        if state == "completed":
            break
        if state in {"failed", "error"}:
            raise RuntimeError("Verarbeitung fehlgeschlagen: " + str(state))
        time.sleep(2)
    else:
        raise TimeoutError("Verarbeitung nicht rechtzeitig abgeschlossen; Datei-ID prüfen.")
    linked = session.post(origin + f"/api/v1/knowledge/{collection}/file/add",
        json={"file_id": file_id}, timeout=(10, 60))
    linked.raise_for_status()
    print("Zuordnung bestätigt. Jetzt Abruf und Quellen mit einer Testfrage prüfen.")

if __name__ == "__main__":
    main()
Ingest-Vorlage als ZIP herunterladen
Aufruf nach geschützter Konfiguration: python3 ingest.py testdokument.pdf. Der Aufruf lädt eine Datei hoch und verändert die ausgewählte Sammlung. Zuerst eine Testsammlung verwenden. Nach einem Verbindungsabbruch Datei-ID und Sammlungsbestand prüfen, bevor erneut geschrieben wird.
Streaming und Antwortformate
stream: false wartet auf eine vollständige Antwort. Echte gestreamte Antworten benötigen eine passende Ereignisverarbeitung, Abbruchbehandlung und ein geprüftes Quellenformat. Eine nachträgliche Zeichenanimation im Browser ist kein Serverstream. Quellenfelder sind nicht automatisch zwischen allen Modellen, Diensten und Plugins identisch.
Fehler und Zugang
HTTP 401 deutet auf fehlende oder ungültige Authentifizierung, 403 auf fehlende Berechtigung, 404 auf Pfad oder Ressource und 429 auf eine Begrenzung hin. Diese Codes sind Diagnosehinweise; der konkrete Antwortkörper und vorgelagerte Proxy werden mit betrachtet. Bei 5xx werden Gateway und Modelldienst getrennt untersucht. Vertrauliche Antworten oder Tokens gehören nicht in öffentliche Fehlermeldungen.
Externe Integrationen und WordPress-Chatbot
Externe Anwendungen sprechen Nova serverseitig an. Der Integrationsserver authentifiziert den Aufrufer, begrenzt Eingaben und entscheidet, welches Modell und welche Sammlung verwendet werden dürfen. Ein öffentliches Formular sollte diese IDs nicht frei durch den Browser steuern lassen.
WordPress-Chatbot
Die ausgewertete Plugin-Fassung 1.0.5 vermittelt über eine eigene WordPress-REST-Route /wp-json/neos-quantum-nova-chat/v1/chat zur Nova-API. Der Nova-Zugang bleibt serverseitig. Modell und optionaler Wissensbezug werden in der serverseitigen Konfiguration festgelegt. Diese Beschreibung belegt die untersuchte Fassung, nicht die aktuell auf einer bestimmten Website installierte Plugin-Version.
Die untersuchte Fassung fordert die vollständige Nova-Antwort mit stream: false an und zeigt sie anschließend schrittweise an. Das ist keine Ende-zu-Ende-SSE-Verbindung. Die Verarbeitung von Quellen erwartet ein bestimmtes Antwortfeld; dessen Kompatibilität ist mit der angebundenen Nova-Version zu testen.
Öffentliche Nutzung absichern
Ein WordPress-Request-Token ist kein allgemeiner Identitätsnachweis für anonyme Besucher. Zugriffsregeln, Ratenbegrenzung und gegebenenfalls ein Schutz gegen automatisierte Anfragen ergänzen sich. Das Integrationskonto erhält ausschließlich Zugriff auf die dafür freigegebenen Sammlungen. Private Chats und interne Dokumente werden nicht für einen öffentlichen Bot freigegeben.
Die untersuchte Plugin-Konfiguration kann ausführliche Protokollierung vorsehen. Wenn Fragen und Antworten protokolliert werden, müssen Umfang, Zugriff und Löschfristen ausdrücklich festgelegt werden. Ein frontendseitiger Datenschutzhinweis ersetzt keine technische Prüfung des Datenwegs.
Abnahme einer Integration
Ein sinnvoller Abnahmelauf umfasst normale Antwort, fehlende Antwort, Modellfehler, Timeout, unerlaubte Sammlung, überschrittenes Limit und einen Abbruch durch den Benutzer. Dabei werden Browser, WordPress-Server, Nova und Modellgateway als getrennte Fehlerquellen betrachtet. Die in diesem Paket enthaltenen Python-Beispiele sind Alternativen für serverseitige Integrationen und kein Browsercode.
Authentifizierung, Rollen und Zugriffsrechte
Authentifizierung klärt, wer zugreift. Autorisierung klärt, welche Ressourcen und Aktionen erlaubt sind. Ein gültiger API-Schlüssel berechtigt nicht automatisch zum Zugriff auf alle Dokumente. Technische Konten sollten einem klaren Integrationszweck zugeordnet und mit minimalen Rechten ausgestattet sein.
Benutzer und technische Konten
Administratorzugriffe werden von normalen Arbeitskonten getrennt. Ein Integrationskonto erhält nur die erforderlichen Modelle und Wissensressourcen. Schlüssel werden über eine geschützte Konfiguration bereitgestellt. Ob mehrere gleichzeitig gültige oder benannte Schlüssel unterstützt werden, ist versionsabhängig; dieses Handbuch setzt dafür kein unbestätigtes Verhalten voraus.
Rechte prüfen
- Eine geschützte Testsammlung und einen berechtigten Benutzer festlegen.
- Mit diesem Benutzer eine bekannte Passage abrufen.
- Den gleichen Abruf mit einem Benutzer ohne Freigabe versuchen.
- Den Test über die API und gegebenenfalls über den öffentlichen Chatbot wiederholen.
- Auch direkte Datei- und Ressourcenabrufe sowie exportierte Preset-Bezüge prüfen.
Ein Systemprompt wie »verwende nur erlaubte Dokumente« ersetzt keine dieser Kontrollen. Projektordner, Presets und Anzeigenamen sind ebenfalls keine alleinige Sicherheitsgrenze. Ein Anspruch auf Mandantentrennung benötigt eine gesonderte Prüfung von Speicher, APIs, Ressourcen und Administratorrechten.
Identitätsanbieter und Schlüsselwechsel
Die konkrete lokale Anmeldung oder externe Identitätsanbindung wird pro Installation dokumentiert. SSO, Rollenübernahme und automatisches Entfernen ausgeschiedener Personen werden nicht ohne Einrichtung zugesichert. Für Schlüsselwechsel werden betroffene Integrationen erfasst, die neue Konfiguration geprüft und alte Zugänge kontrolliert entzogen. Das Verfahren muss zur tatsächlich unterstützten Schlüsselverwaltung passen.
Sicherheit, Datenschutz und Governance
Der technische Datenweg wird pro Betriebsprofil und Modell festgehalten. Dazu gehören Originaldateien, extrahierter Text, Dokumentvektoren, Fragen, Antworten, Gesprächsverlauf und Protokolle. Vektoren können Informationen über Ausgangsinhalte tragen; sie werden nicht pauschal als anonym behandelt.
| Bereich | Erforderliche Festlegung |
|---|---|
| Transport und Netze | HTTPS für Benutzer- und externe API-Zugänge; interne Dienste nur in vorgesehenen Netzen. |
| Secrets | Geschützte Bereitstellung, minimale Rechte, kontrollierter Wechsel und kein Einbau in Frontend oder Dokumentationspaket. |
| Dokumente | Verantwortung, Datenklasse, zulässige Nutzer, Aufbewahrung und Umgang mit Änderungen. |
| Modellanbieter | Betreiber, Region, Vertrag, Aufbewahrung und freigegebene übertragene Inhalte. |
| Protokolle | Zweck, Datenumfang, Zugriff und Löschfrist; keine pauschale Vollprotokollierung vertraulicher Inhalte. |
| Werkzeuge | Begrenzte Aktionen, validierte Parameter und zusätzliche Freigabe bei folgenreichen Vorgängen. |
Inhalte und Anweisungen trennen
Ein eingelesenes Dokument ist eine Informationsquelle. Enthaltene Anweisungen an das Modell dürfen nicht automatisch Integrationsrechte erweitern oder Daten an neue Ziele senden. Eingaben und Werkzeugausgaben werden als nicht vertrauenswürdig behandelt. Ausgaben des Modells werden vor einer weiteren technischen Verarbeitung nach erwartetem Format und erlaubten Werten validiert.
Löschen und Nachvollziehbarkeit
Ein Löschverfahren muss Originaldatei, Suchindex, Anwendungsbezüge, gegebenenfalls Chatkopien und Sicherungskonzept berücksichtigen. Ein entfernter Eintrag in der Oberfläche belegt nicht allein die vollständige Löschung aller Kopien. Für Sicherungen gelten gesonderte Aufbewahrungs- und Wiederherstellungsregeln. Die konkrete Umsetzung wird in einem installationsbezogenen Betriebskonzept festgehalten.
Dieses Handbuch beschreibt technische Maßnahmen. Es ersetzt weder eine Vertragsprüfung noch eine Bewertung der konkreten Verarbeitung. Private Cloud, lokale Inferenz und verschlüsselte Übertragung sind Bausteine; daraus folgt keine pauschale Konformitätszusage.
Betrieb, Updates und Wiederherstellung
Ein stabiler Betrieb braucht eine nachvollziehbare Zuordnung von Produktversion, Containerstand, Konfiguration, Modellen und Datenbestand. Ein eigener Anzeigename oder Image-Label ist kein vollständiger Versionsnachweis. Änderungen werden zuerst in einer getrennten Umgebung mit einem definierten Testsatz geprüft.
Sicherungsumfang
Gesichert werden der persistente Nova-Anwendungsbereich einschließlich Dateibestand, Metadaten und Index, die erforderlichen Konfigurationen und sicher verwalteten Geheimnisse sowie gegebenenfalls Gateway-Datenbank und Gateway-Konfiguration. Modelldateien können je nach Wiederanlaufziel gesichert oder reproduzierbar erneut bereitgestellt werden. Dafür sind exakte IDs und verfügbare Bezugswege nötig.
Die belegte Installation verwendet einen persistenten Nova-Datenbereich und ein separates Ollama-Modellvolume. Die Datenbank des getrennten LiteLLM-Stacks benötigt ein eigenes konsistentes Sicherungsverfahren. Ein Preset-Export oder eine einzelne Indexdatei ersetzt keine Gesamtsicherung.
Update-Verfahren
- Zielversion, Änderungen, Wartungsfenster und Rückkehrkriterien festhalten.
- Konsistente Sicherung erstellen. Schreibzugriffe nach dem unterstützten Verfahren pausieren oder koordinieren.
- Eine getrennte Wiederherstellung mit den gesicherten Daten prüfen.
- Update in dieser Testumgebung ausführen und Anmeldung, Chat, Rechte, Ingest, Abruf und Integrationen prüfen.
- Erst nach Freigabe die produktive Umgebung umstellen und den gleichen Kernprüfsatz wiederholen.
Nach einer Datenmigration kann ein älteres Containerimage mit dem neuen Datenbestand inkompatibel sein. Eine Rückkehr erfordert deshalb gegebenenfalls die passende Sicherung von Anwendung und Daten. Das bloße Zurücksetzen eines Image-Tags ist kein abgesichertes Rollback.
Wiederherstellung und Neuindizierung
Eine Wiederherstellung erfolgt zunächst isoliert, damit keine produktiven Integrationen, Benachrichtigungen oder Schreibvorgänge ausgelöst werden. Benutzer, Rechte, Stichproben der Originaldateien und bekannte Suchfragen werden geprüft. Wiederanlaufzeit und zulässiger Datenverlust werden im Betriebskonzept festgelegt und gemessen.
Die Oberfläche bietet Aktionen zum Zurücksetzen von Uploads, zum Zurücksetzen von Vektorspeicher und Wissen sowie zur Neuindizierung an. Diese sind keine allgemeine Fehlerbehebung. Vor ihrer Nutzung werden Sicherung, Umfang, Dauer und Auswirkung auf den Bestand geprüft. Für diesen Dokumentationsentwurf wurde keine dieser Aktionen ausgeführt.
Diagnose und Prüfverfahren
Die Diagnose folgt dem Datenweg. Zuerst wird geprüft, ob die Anfrage Nova erreicht. Danach werden Berechtigung, Ressource, Verarbeitung, Abruf und Modelldienst getrennt untersucht. So bleibt erkennbar, ob ein Fehler durch Extraktion, Suche oder Antworterstellung entsteht.
| Beobachtung | Zuerst prüfen | Nächster Nachweis |
|---|---|---|
| Datei bleibt in Verarbeitung | Datei-ID, Status und Ingest-Protokoll | Kurze Textdatei als Vergleich; Parser und Embedding-Dienst getrennt prüfen. |
| PDF-Antwort enthält keine Inhalte | Textschicht, Scan, Extraktion und Seiten | Bekannte Passage im extrahierten Text suchen. |
| Falsche Dokumentpassage | Sammlung, aktiver Index, Chunk-Bezug und hybride Suche | Abruf ohne Bewertung der formulierten Antwort untersuchen. |
| Richtige Quelle, falsche Aussage | Kontext, Einheiten, Widerspruch und Modell | Passage mit generierter Aussage vergleichen. |
| Nach Modellwechsel schlechte Treffer | Embedding-ID, Dimension und Indexstand | Dokumente und Fragen müssen denselben Vektorraum nutzen. |
| Lange Antwortzeit | Warmzustand, Warteschlange, Reranking und Modellaufruf | Zeit pro Stufe messen; keinen pauschalen GPU-Effekt unterstellen. |
| API funktioniert, Website nicht | WordPress-Konfiguration, Limits, Timeout und Antwortformat | Serverantwort und Frontend getrennt prüfen. |
| Geschützte Inhalte sichtbar | Integrationskonto und Ressourcenrechte | Zugriff sperren und Rechtepfad untersuchen; nicht nur Prompt ändern. |
Kernprüfsatz für eine Abnahme
- Anmeldung als normaler Benutzer und als Administrator getrennt prüfen.
- Modellkatalog und kurze Chatantwort über die vorgesehene Schnittstelle prüfen.
- Eine Testdatei hochladen, Statusabschluss abwarten und einer Testsammlung zuordnen.
- Eine bekannte Information mit Quelle abrufen und eine fehlende Information abfragen.
- Den Zugriff mit einem nicht berechtigten Konto ablehnen lassen.
- Integration mit Fehler, Timeout und überschrittenem Limit prüfen.
- Gesicherten Stand isoliert wiederherstellen und die Kernfälle erneut ausführen.
Ein Prüfprotokoll enthält Produktstand, Betriebsprofil, Datum, Testfall, Erwartung und Ergebnis. Vertrauliche Inhalte und Zugangsschlüssel werden nicht aufgenommen. Beobachtete Konfiguration und erfolgreicher Lauf werden getrennt festgehalten.
Noch ausstehende technische Bestätigung
Vor einer produktiven Freigabe dieses Referenzstands werden der aktive Vektorbackendpfad, die API-Antwortschemata und Rechte, die konkrete Reindex-Abdeckung sowie eine isolierte Wiederherstellung geprüft. Identitätsanbindung und betriebliche Aufbewahrungsfristen werden je Installation ergänzt. Die am 2026-10-16 abgelesenen Abrufwerte sind für die betrachtete Installation dokumentiert; ihre Eignung wird mit einem passenden Testsatz bewertet. Diese Punkte blockieren die Nutzung des Handbuchs als Entwurf nicht; sie begrenzen seine technische Zertifizierung.
Plugins für NEOs Quantum Nova
Plugins erweitern NEOs Quantum Nova um zusätzliche Funktionen oder binden Nova in andere Anwendungen ein. Dieser Bereich sammelt die jeweiligen Plugin-Dokumentationen. Er wird mit weiteren Plugins und ihren freigegebenen Beschreibungen ergänzt.
WordPress-Plugin
Die technische Beschreibung der WordPress-Chatbot-Anbindung bleibt in Kapitel 12. Dort sind Datenweg, serverseitiger Zugang, Antwortverarbeitung und die zu prüfenden Schutzmaßnahmen beschrieben.
Zur WordPress-Plugin-Dokumentation
Veil
Veil ist ein angekündigtes Plugin zum Schutz personenbezogener Daten.
Details folgen.
Die Beschreibung von Funktionsumfang, Einrichtung und technischen Voraussetzungen wird ergänzt. Dieser Platzhalter bestätigt keine bereits verfügbare Funktion und enthält noch keine Schutz- oder Wirksamkeitszusage.
Downloads, Versionen und Referenzen
Alle Dateien dieses Pakets funktionieren ohne externen Skript- oder Schriftanbieter. Die Dokumentation selbst benötigt weder CMS noch PHP noch Datenbank. Die Python-Integrationsvorlagen benötigen dagegen eine Python-Umgebung, requests, gültige Zugänge und eine erreichbare Nova-Instanz.
Versionsführung
| Angabe | Wert |
|---|---|
| Produktreferenz | NEOs Quantum Nova 26.0.12.0 |
| Handbuch | 1.3.0-Rev4 · 2026-10-16 |
| Status | Zur inhaltlichen und technischen Prüfung; keine Veröffentlichung mit diesem Paket ausgelöst. |
| Technische Evidenz | Bereitgestellte Konfiguration und am 2026-10-16 erneut gelesene Administrationsansichten mit echten Systemaufnahmen; kein vollständiger Laufzeittest. |
Änderungsstand
1.3.0-Rev4 · 2026-10-16: Beide Python-Downloads auf statische ZIP-Archive umgestellt und sämtliche Downloadlinks angepasst. Der Beispielcode bleibt unverändert. Begleitdateien, Manifest und Prüfsummen aktualisiert.
1.3.0-Rev3 · 2026-10-16: Vier echte Systemaufnahmen zu Extraktion und Chunking, Embedding, Abruf sowie Dateigrenzen und Integrationen ergänzt. Konfiguration im angemeldeten System erneut gelesen; Top K 5, Top K Reranker 5 und Relevanzschwelle 0 dokumentiert. Keine Einstellungen verändert.
1.3.0-Rev2 · 2026-10-16: Versionsbezeichnung auf das freigegebene Schema umgestellt. Eigenes Plugin-Kapitel ergänzt; WordPress bleibt in Kapitel 12, Veil ist als angekündigtes Plugin mit »Details folgen« aufgenommen.
1.3.0-Rev1: Vorgängerstand im jetzt festgelegten Versionsschema. Erster zusammenhängender Entwurf mit 17 Kapiteln, Betriebsprofilen, zwei Prozessdiagrammen, Ingest- und Chatvorlagen, Downloadübersicht und weitergeführten Kapitelankern. Die belegten Dokument- und RAG-Einstellungen wurden aufgenommen. Nicht nachgewiesene Laufzeitaussagen werden ausdrücklich begrenzt.
Weiterführende Produktdokumentation
Zur Produktübersicht Zur Anwenderdokumentation
Diese technische Referenz ist für vertiefende Fragen vorgesehen. Bedienanleitungen werden nicht parallel vollständig gepflegt. Installationsbezogene Betriebsdetails und interne Prüfsicherungen gehören nicht in das öffentliche Handbuch.